Redis 센티널 (Sentinel)
Redis 센티널 (Sentinel)
센티널 구성
레플리카 구성에 감시 프로세스(센티널)를 더해, Master가 죽으면 자동으로 failover 하는 구성
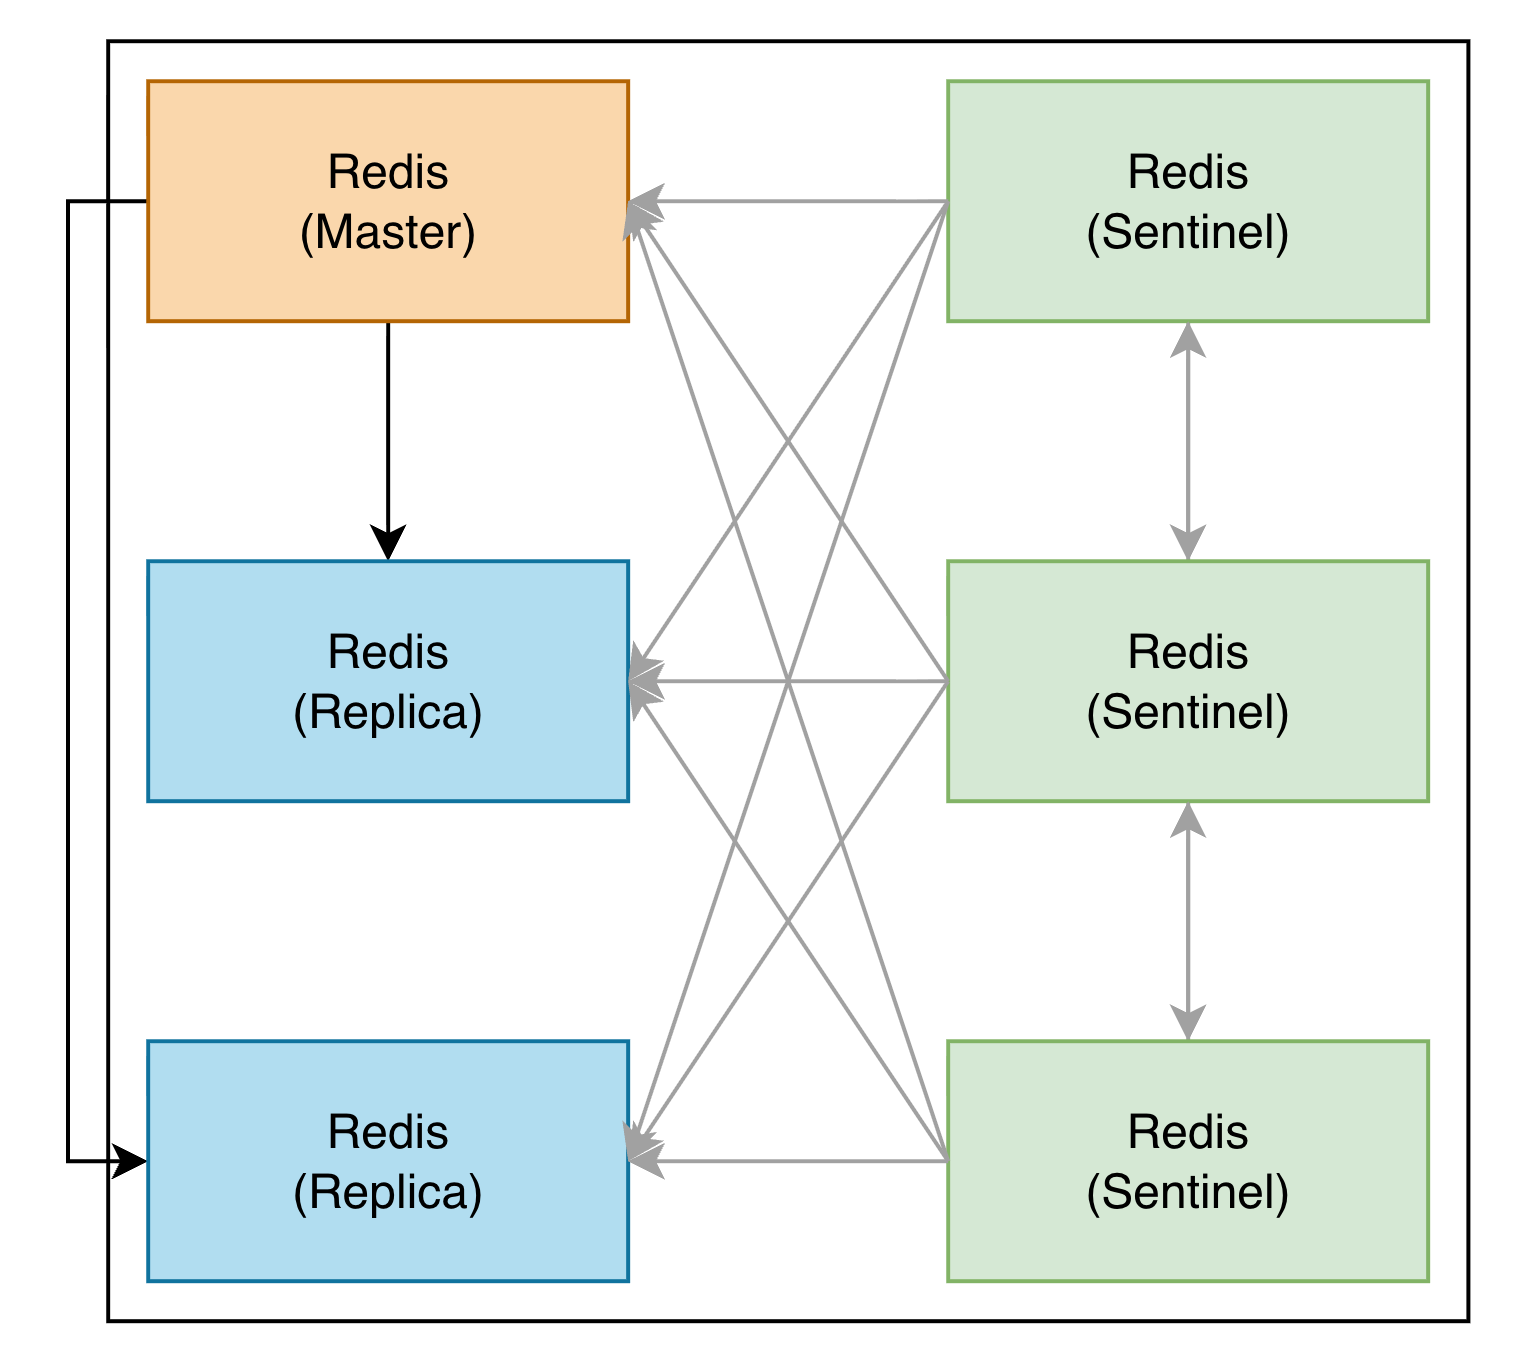
- 고가용성(HA, High Availability)은 장애가 나도 서비스가 계속되는 성질이다. 레플리카가 넘겨받을 대상(이중화)을 만들었다면, 센티널은 넘기는 일(failover)을 자동화해서 HA를 완성한다.
- 센티널도 여러 대를 두고, 서로 감시와 합의를 통해 장애를 판정한다.
- 3대 이상, 홀수로 둔다. 과반이 성립해야 failover가 실행되므로, 2대면 한 대만 죽어도 과반이 불가능하다.
- 서로 다른 호스트에 배치한다. 한 호스트에 몰아두면 그 호스트 장애로 Master와 센티널 과반이 함께 사라진다.
- 감시자 스스로가 SPOF(단일 장애점)가 되지 않게 하기 위한 조건들이다.
센티널 시작 과정
sentinel.conf에 감시할 Master 정보를 설정하면 감시 시작
1
sentinel monitor [이름] [Master IP] [Master Port] [quorum]
- 센티널이 Master에 TCP connect
- INFO replication(10초 주기)으로 Replica 주소를 획득하고, Replica에도 TCP connect
- __sentinel__:hello 채널 pub/sub(2초 주기)으로 다른 센티널을 발견하고, 양방향 TCP connect
Master 주소만 알려주면, Replica와 다른 센티널은 스스로 찾아낸다.
저장과 조회
저장과 조회는 레플리카 구성과 동일하게 Master/Replica가 처리
- 데이터 명령은 센티널을 거치지 않고 Redis에 직접 전달된다. (센티널 ≠ 프록시)
- 센티널을 지원하는 클라이언트는 센티널에게 현재 Master 주소만 질의한다.
- 질의는 SENTINEL get-master-addr-by-name [이름], 변경 통지는 +switch-master 채널로 이루어진다.
- 그래서 클라이언트 설정에는 Master 주소가 아니라, 센티널 주소 목록과 Master 이름을 넣는다.
- Master는 RW, Replica는 기본 RO다.
- 조회 분산 : 클라이언트 설정으로 조회를 Replica에 보낼 수 있다.
장애 판정 과정
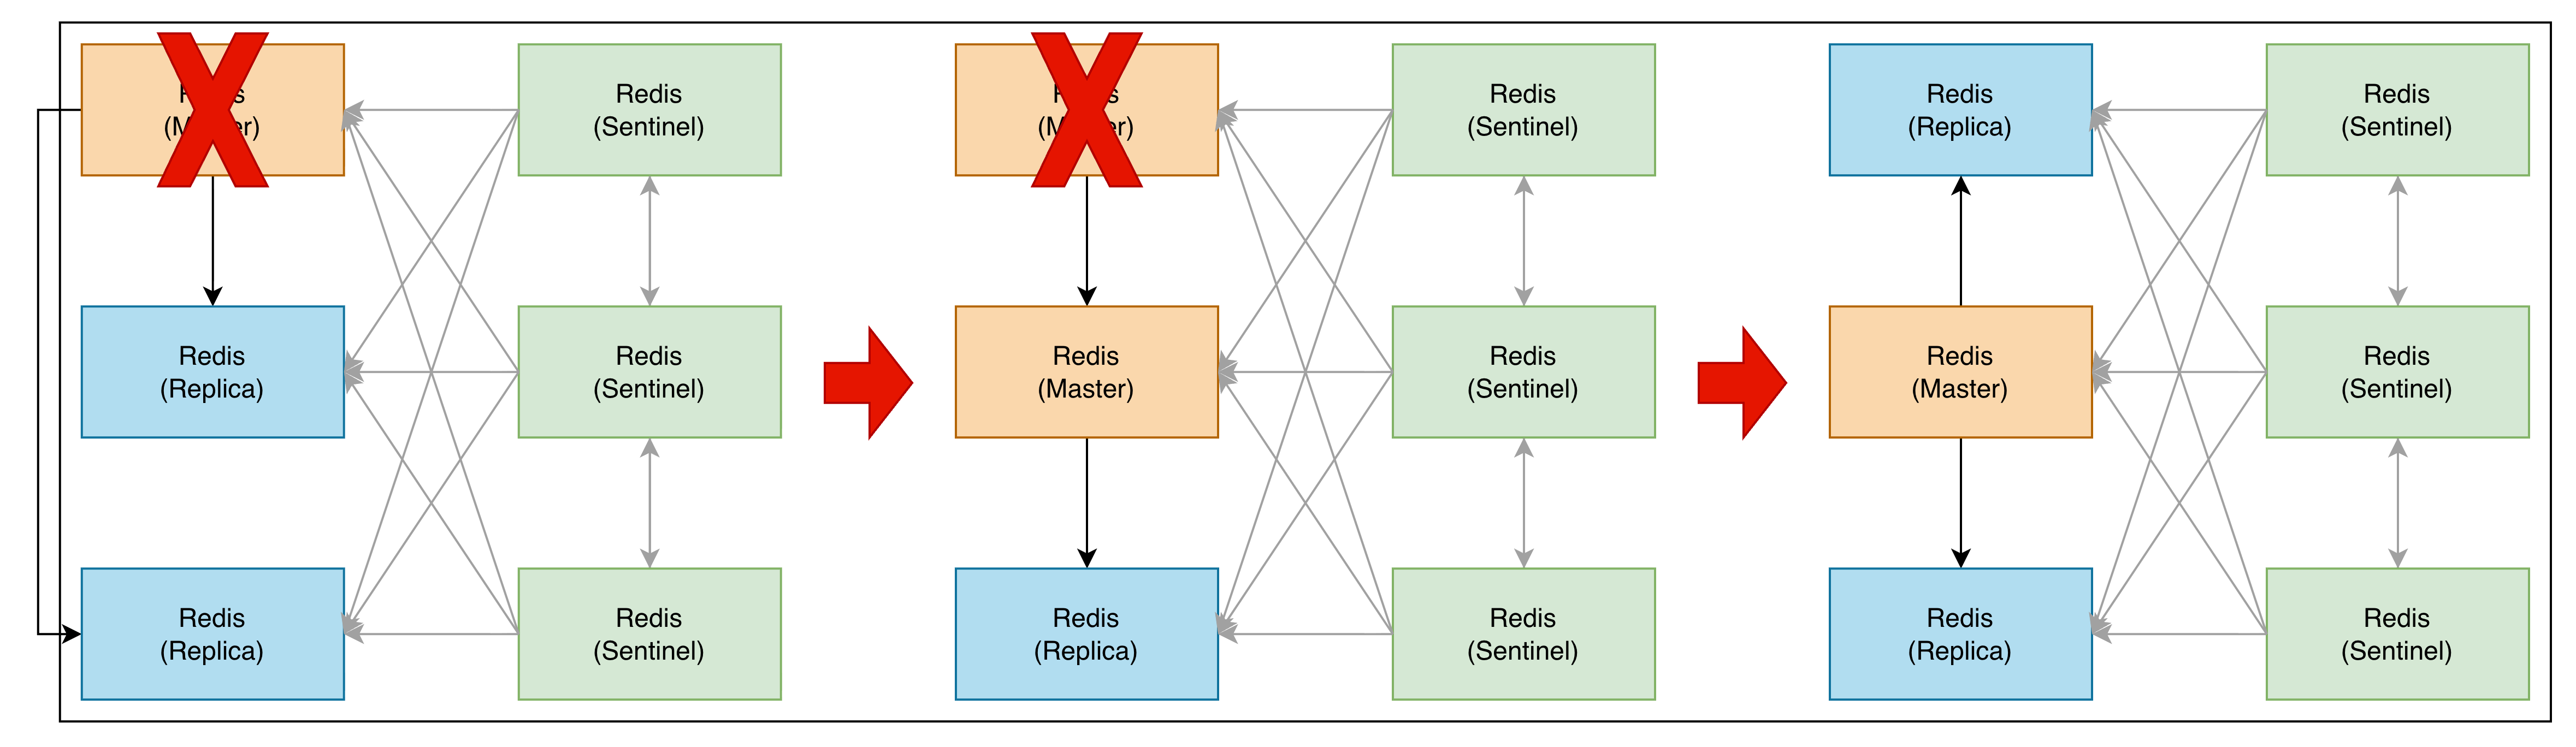
- PING (1초 주기) : down-after-milliseconds 동안 응답이 없으면 SDOWN 판정 (주관적 다운)
- SENTINEL is-master-down-by-addr [ip] [port] [epoch] [runid] 로 다른 센티널에게 질의한다. runid 값에 따라 용도가 나뉜다.
- runid=* : 죽었는지 의견을 수집한다. quorum 이상이 동의하면 ODOWN 판정 (객관적 다운)
- runid=본인id : epoch 투표를 요청한다. 과반을 얻으면 리더로 선출되어 failover를 실행한다.
- ODOWN은 Master에만 적용된다. Replica와 센티널은 SDOWN까지만 판정한다.
레플리카 편에서 Replica가 스스로 승격하지 못한 이유는, Master가 죽은 것인지 자신의 네트워크가 끊긴 것인지 혼자서는 구분할 수 없어서였다. 센티널은 이 판단을 여럿의 합의로 바꾸고, 합의를 두 단계로 나눈다.
- 판정 (quorum) : quorum 이상이 동의해야 ODOWN → 한 대의 네트워크 문제로는 장애로 판정되지 않는다.
- 실행 (과반) : 과반의 표를 얻은 리더만 failover 실행 → 네트워크가 갈라져도 소수 쪽에서는 승격이 일어나지 않는다.
quorum은 장애를 인정하는 기준이고, 과반은 failover를 실행할 권한이다.
quorum을 1로 낮춰도, 센티널 과반이 살아 있지 않으면 failover는 실행되지 않는다.
failover 과정
리더로 선출된 센티널이 failover 실행
- 승격할 Replica를 선정한다. (연결이 오래 끊긴 Replica 제외 → replica-priority 낮은 순 → 복제 offset 큰 순 → runid 순)
- REPLICAOF NO ONE으로 승격시킨다.
- 나머지 Replica를 새 Master에 재연결한다. (parallel-syncs 만큼씩)
- 새 구성을 hello 채널로 전파하고, 옛 Master는 복구되면 Replica로 강등한다.
- 센티널은 자신의 sentinel.conf를 갱신하고, 각 Redis에는 CONFIG REWRITE를 보내 redis.conf에도 새 구성이 기록되게 한다. (재시작해도 새 구성 유지)
failover 관련 설정
1
2
3
sentinel down-after-milliseconds [이름] [ms]
sentinel failover-timeout [이름] [ms]
sentinel parallel-syncs [이름] [개수]
- down-after-milliseconds : PING 응답이 이 시간 동안 없으면 SDOWN (default 30초)
- failover-timeout : failover 한 번의 전체(리더 선출 재시도 간격, 옛 Master 강등 대기 등) 제한 시간 (default 3분)
- parallel-syncs : failover 후 Replica 몇 개를 동시에 새 Master에 재동기화 할지 결정 (default 1개씩)
레플리카 vs 센티널
| 레플리카 | 센티널 | |
|---|---|---|
| 목적 | 데이터 이중화 | 고가용성(HA) |
| failover | 수동 (사람) | 자동 (센티널의 합의) |
| 장애 감지 | 알람으로 사람이 인지 | PING → SDOWN → quorum 합의로 ODOWN |
| 승격 | 사람이 offset이 가장 큰 Replica를 골라 승격 | 리더가 우선순위·offset 기준으로 선정 후 승격 |
| 복제 재구성 | 사람이 나머지 Replica와 옛 Master를 재설정 | 나머지 Replica와 돌아온 옛 Master까지 자동 재설정 |
| 클라이언트 전환 | 설정의 Master 주소를 직접 변경 | 클라이언트가 센티널에 질의, 변경은 Pub/Sub으로 통지 |
레플리카가 넘겨받을 대상을 만들고, 센티널이 넘기는 일을 자동화해서 HA가 완성된다.
자동화가 해결하지 못하는 것
failover는 자동화됐지만, 그 사이의 공백은 존재
- 다운타임 : down-after-milliseconds(default 30초) + 리더 선출 + 승격 시간만큼 write가 막힌다.
- 판정 시간을 줄이면, 일시적 지연을 장애로 판정하는 오탐이 늘어난다.
- 데이터 유실 : 비동기 복제라서 전파되지 않은 write는 승격 시 사라지고, 네트워크 분리 시 소수 쪽에 고립된 옛 Master가 받은 write는 강등되면서 버려진다.
- 레플리카 편의 min-replicas-to-write가 여기서 본격적으로 의미를 가진다. 고립된 Master가 min-replicas-max-lag 이후부터는 write를 거부하므로, 버려질 write의 폭을 줄인다.
센티널로 failover를 자동화했다.
하지만 데이터 용량이 Master 한 대의 메모리보다 커진다면 어떻게 해야 할까?
다음 편에서는 데이터를 여러 Master에 나눠 담아 이 한계를 해결하는 클러스터를 다룬다.
Redis 아키텍처 시리즈
- 싱글 구성과 영속성 (RDB, AOF)
- 레플리카 (Replication)
- 센티널 (Sentinel)
- 클러스터 (Cluster)
This post is licensed under CC BY 4.0 by the author.