Redis 클러스터 (Cluster)
Redis 클러스터 (Cluster)
클러스터 구성
데이터를 여러 Master에 나눠서 저장하고, 별도 감시자 없이 노드끼리 장애를 판정하는 구성
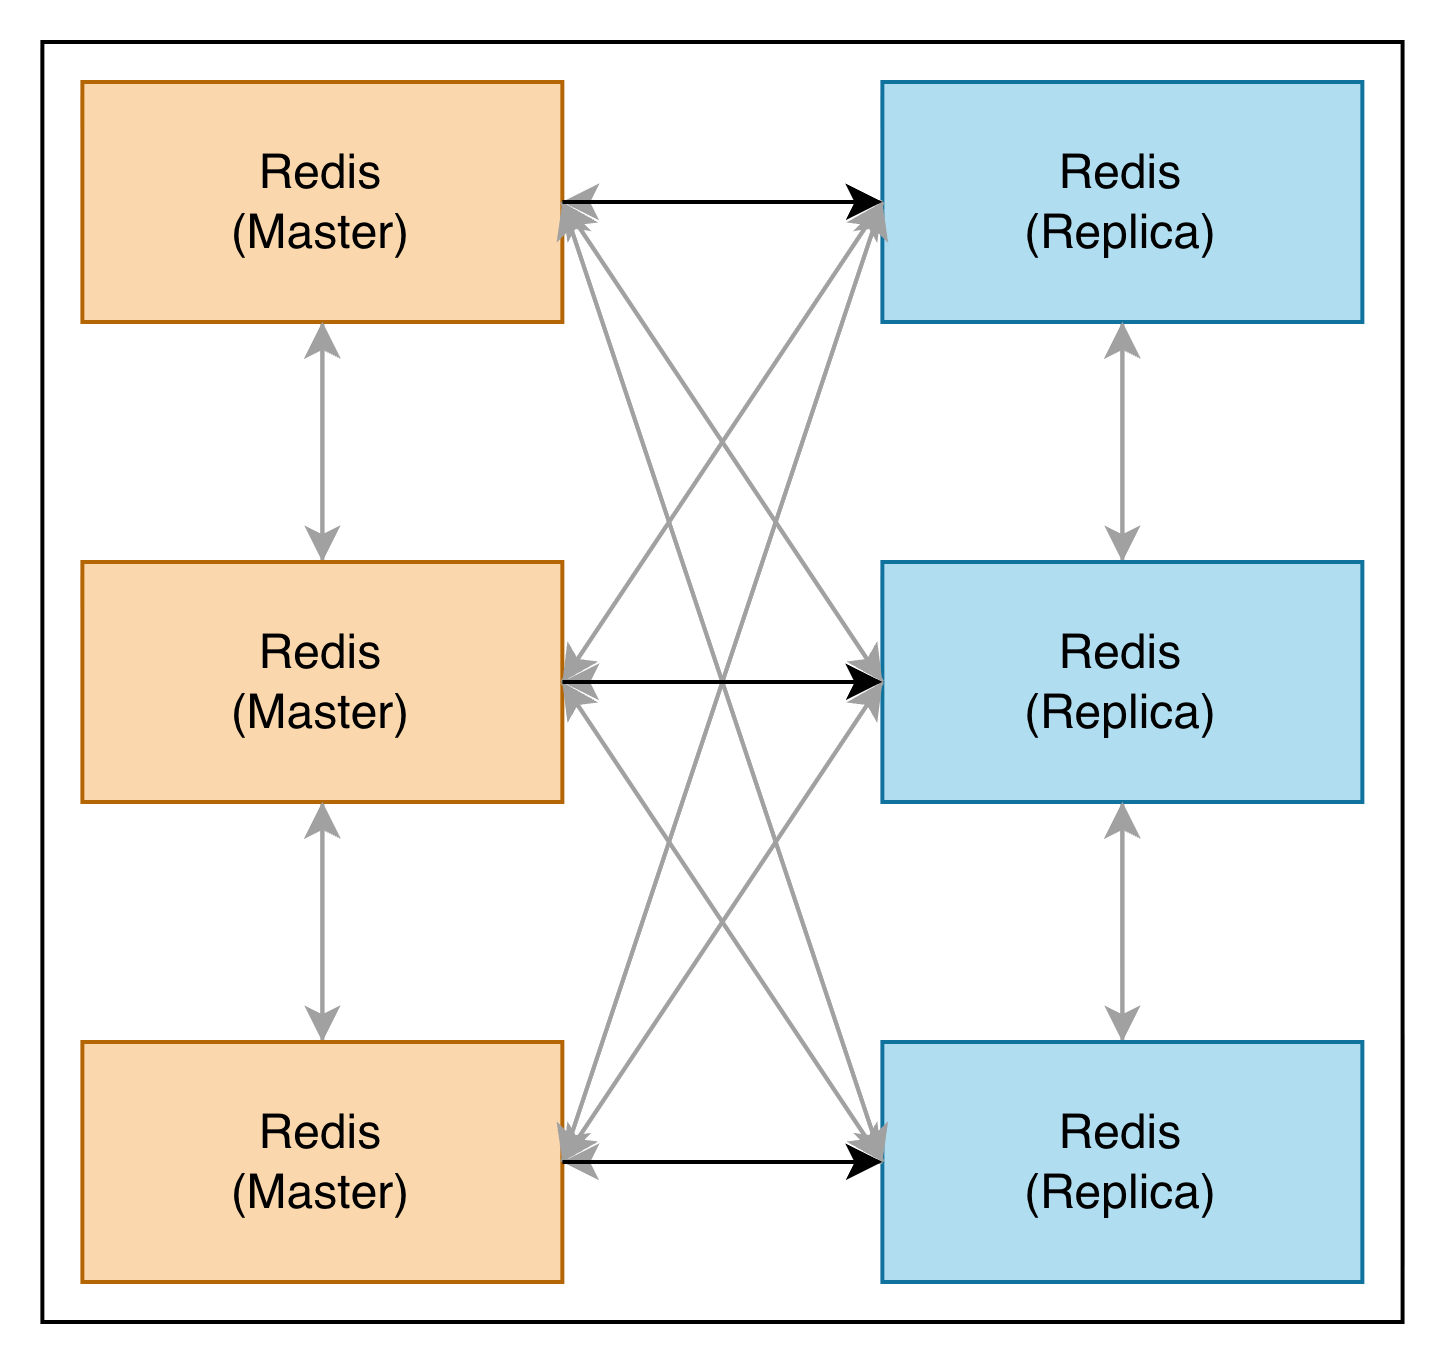
- 센티널까지로 failover는 자동화됐지만, write와 메모리는 여전히 Master 한 대의 한계에 갇혀 있다. 그래서 데이터 자체를 나눈다.
- 센티널과 달리 감시 전용 프로세스가 없고, 노드 간 gossip으로 서로 감시한다. 고가용성(HA)은 클러스터에 내장되어 있어, 센티널을 따로 두지 않는다.
- 데이터는 16384개의 슬롯으로 나뉘어 Master들에 분배된다.
- Master는 3대 이상이어야 한다. FAIL 판정과 승격 승인 모두 Master 과반이 하므로, 2대면 한 대 장애 시 과반이 성립하지 않는다. (센티널을 3대 이상 두는 것과 같은 논리)
클러스터 시작 과정
각 노드의 redis.conf에 클러스터 모드를 설정하면, 각자 단독 클러스터로 기동
1
2
3
cluster-enabled yes
cluster-config-file nodes.conf
cluster-node-timeout [ms]
최초 1회, 노드들을 하나의 클러스터로 병합
1
redis-cli --cluster create [6개 노드 주소] --cluster-replicas 1
- CLUSTER ADDSLOTS : 16384개 슬롯을 Master 3개에 분배
- CLUSTER MEET : 노드들을 서로 소개 (일부에게만 보내도 gossip으로 전체에 퍼진다)
- 합류가 클러스터 전체에 전파될 때까지 대기
- CLUSTER REPLICATE : Replica가 자신의 Master를 지정
- 알게 된 토폴로지는 각 노드가 nodes.conf에 기록
- gossip은 데이터 포트가 아니라, 포트+10000(예: 16379)의 클러스터 버스라는 별도 연결로 오간다.
저장과 조회 : 슬롯 분배
모든 키는 16384개의 슬롯 중 하나에 속하고, 각 슬롯은 정확히 하나의 Master가 담당
1
슬롯 번호 = CRC16(키) mod 16384
- 키를 노드에 직접 매핑하지 않고 슬롯을 사이에 두는 이유 : 노드가 늘거나 줄어도 키를 다시 계산할 필요 없이, 슬롯 단위로 옮기기만 하면 된다.
- 해시태그 : {user:1}:profile, {user:1}:cart처럼 키에 중괄호가 있으면 그 안의 문자열({user:1})만 해싱한다. 그래서 관련 키들을 같은 슬롯에 모을 수 있다.
- 남용하면 특정 슬롯에 키가 몰리는 hot slot이 생긴다.
- 여러 키를 다루는 명령(MSET, 트랜잭션 등)은 모든 키가 같은 슬롯에 있어야 한다. 슬롯이 다르면 CROSSSLOT 에러가 발생한다.
저장과 조회 : 요청 라우팅 (MOVED)
슬롯 담당이 아닌 노드는 담당 노드의 주소를 알려주므로(MOVED), 클라이언트는 아무 노드에나 명령 전송 가능
- 노드는 키의 슬롯을 계산하고, 자신이 담당하는 슬롯이면 그대로 처리한다.
- 담당이 아니면 MOVED [슬롯] [담당 노드 주소] 에러로 응답한다.
- 클라이언트는 MOVED를 받으면 슬롯 맵을 갱신하고, 이후 같은 슬롯의 요청은 처음부터 담당 노드로 보낸다.
- 노드는 요청을 대신 전달(proxy)하지 않고 리다이렉트만 한다. 즉 라우팅 책임은 클라이언트에 있다.
- 클러스터를 지원하는 클라이언트는 시작할 때 슬롯 맵 전체를 받아 캐싱한다. MOVED는 맵이 낡았을 때의 보정 수단이다.
- 슬롯을 담당하는 Master는 RW, 그 Replica는 기본 RO다.
- 조회 분산 : Replica는 기본적으로 조회 요청도 MOVED로 Master에 돌려보낸다. 연결에서 READONLY를 보내야 Replica가 직접 조회를 처리한다.
리샤딩 : 슬롯 마이그레이션
노드 추가/제거 시, 서비스를 멈추지 않고 슬롯 이동 가능
1
2
redis-cli --cluster reshard [노드 주소]
redis-cli --cluster rebalance [노드 주소]
- reshard : 어느 슬롯을 몇 개, 어디로 옮길지 직접 지정한다.
- rebalance : 균등 분배가 되도록 필요한 이동을 계산해서 자동으로 수행한다. 노드 추가 시에는 보통 이쪽을 쓴다.
- 대상 슬롯을 목적지 노드에 IMPORTING, 출발지 노드에 MIGRATING 상태로 표시한다.
- 슬롯 안의 키들을 MIGRATE 명령으로 배치 단위로 옮긴다.
- 다 옮기면 슬롯 소유권을 확정(CLUSTER SETSLOT … NODE)하고, 변경이 gossip으로 전파된다.
- 이동 중인 슬롯의 키 요청 처리
- 출발지에 있는 키 → 출발지가 그대로 처리한다.
- 출발지에 없는 키(이미 옮겨졌거나 새 키) → 출발지가 ASK [슬롯] [목적지 주소]로 응답한다.
- ASK를 받은 클라이언트는 목적지에 ASKING을 먼저 보내고, 이어서 원래 명령을 보낸다.
- 목적지는 아직 슬롯의 공식 소유자가 아니라서, ASKING 없이 온 요청은 MOVED로 출발지에 돌려보낸다.
- ASKING은 이동 중인 슬롯의 요청을 이번 한 번만 받도록 하는 일회용 허가다.
- 새로 만들어지는 키도 ASK를 타고 목적지에 생성된다. 출발지에 새 키가 쌓이지 않게 하는 장치다.
- 멀티키 명령이 마이그레이션 중인 슬롯에 걸리면, 키가 양쪽에 나뉘어 있는 동안 TRYAGAIN 에러를 받는다.
- MOVED와 ASK의 차이
- MOVED : 슬롯 이동 완료, 클라이언트는 슬롯 맵 갱신
- ASK : 슬롯 이동 중, 이번 요청만 목적지로 보내고 슬롯 맵 유지
장애 판정 과정
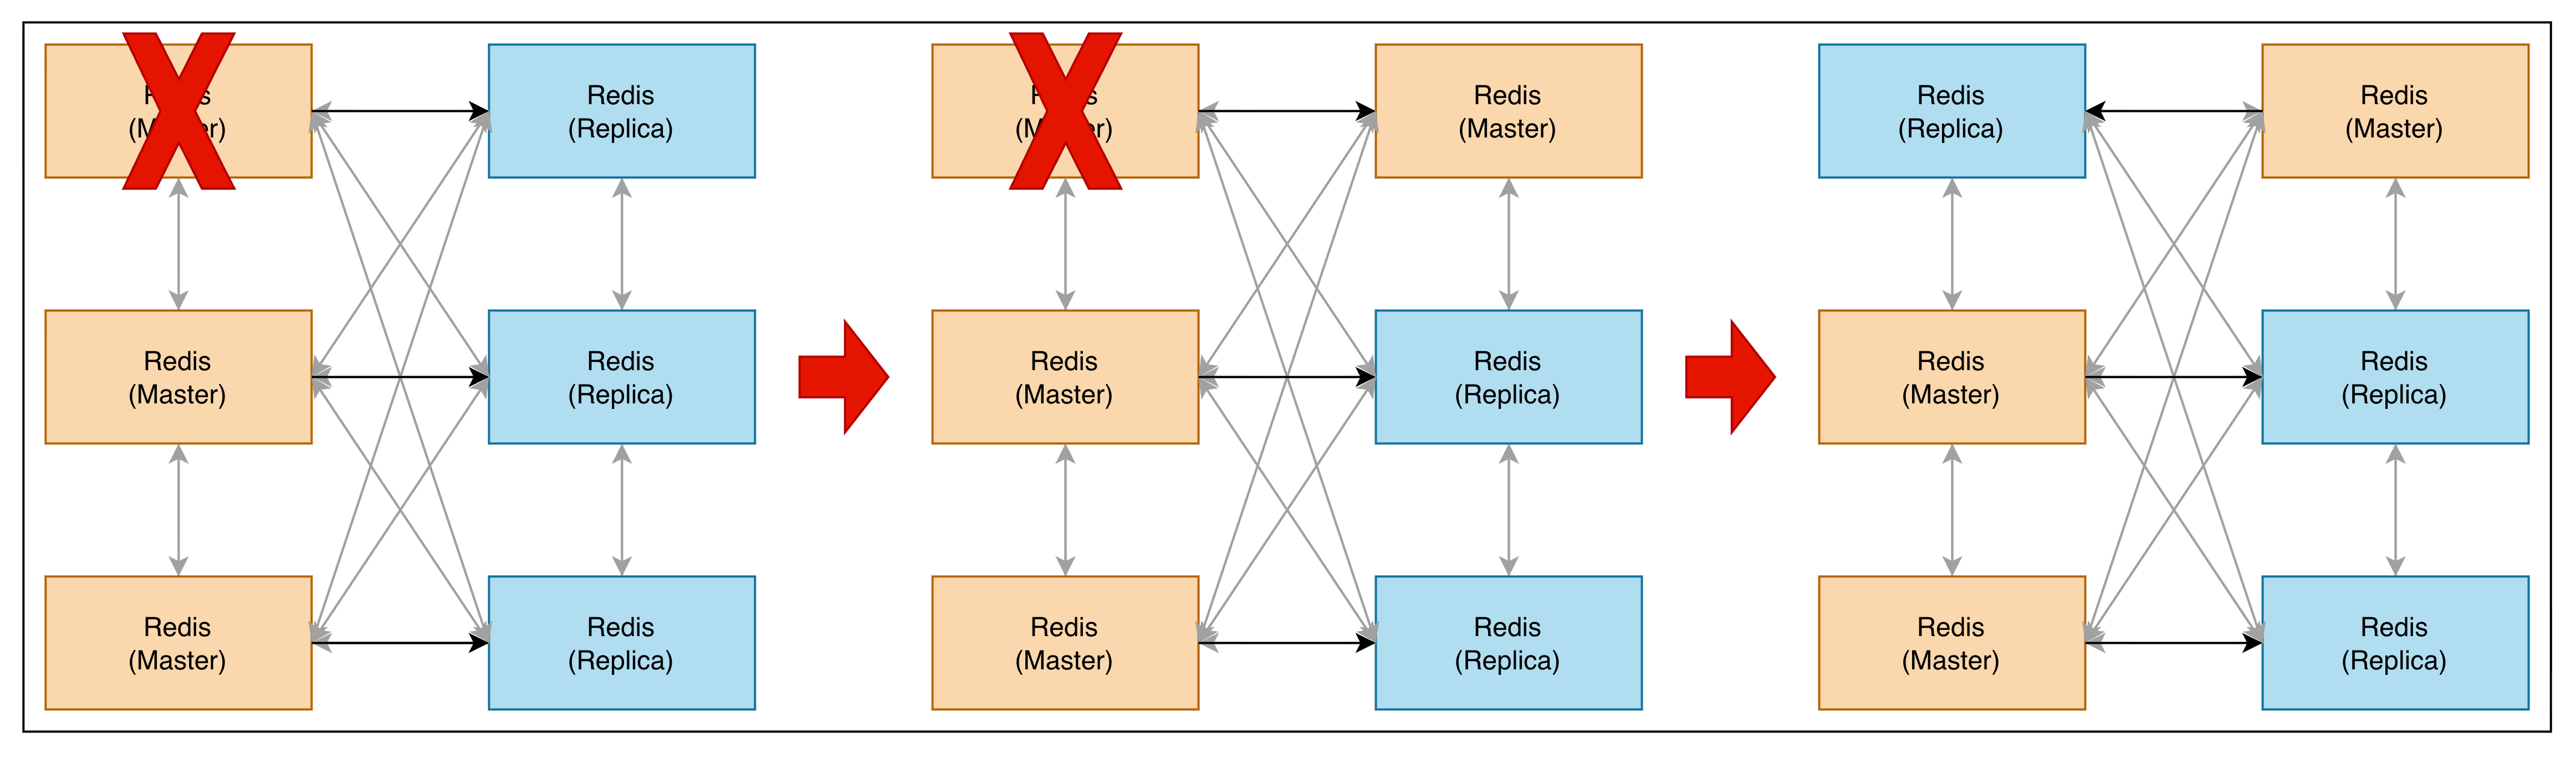
- PING/PONG (매초 랜덤 노드) : node-timeout 동안 응답이 없으면 PFAIL 판정 (주관적 다운)
- 평소의 PING/PONG 메시지에 실어 의견을 교환한다. 메시지는 두 영역으로 나뉜다.
- 헤더 : 내 노드ID / 역할 / 담당 슬롯 / epoch / 내 마스터ID
- gossip 영역 : 내가 아는 다른 노드들의 상태(PFAIL 등). Master 과반이 PFAIL로 보고하면 FAIL 확정 후 전체 브로드캐스트 (객관적 다운)
- FAIL을 인지한 Replica가 FAILOVER_AUTH_REQUEST로 투표를 요청한다. Master 과반이 승인하면 failover를 실행한다.
- 별도 명령 없이, 평소의 PING/PONG만으로 노드 발견과 의견 수집이 함께 이루어진다.
센티널과 같은 두 단계 합의지만, 합의하는 주체가 센티널이 아니라 Master들이다.
- 판정 (Master 과반) : Master 과반이 동의해야 FAIL → 한 노드의 네트워크 문제로는 장애로 판정되지 않는다.
- 실행 (Master 과반) : Master 과반의 승인을 받은 Replica만 승격 → 네트워크가 갈라져도 소수 쪽에서는 승격이 일어나지 않는다.
센티널과 달리 quorum 설정이 없다. 판정과 실행 모두 Master 과반이 기준이다.
failover 과정
Master 과반의 승인을 받은 Replica가 스스로 failover 실행
- 승격해서 옛 Master의 슬롯을 인수한다.
- 승격을 지정해주는 리더는 없다. 대신 복제 offset이 가장 앞선 Replica가 가장 먼저 투표를 요청하도록, 요청까지의 지연이 차등 적용된다.
- 새 Master가 슬롯 소유권을 gossip으로 전파하고, 옛 Master는 복구되면 새 Master의 Replica로 합류한다.
- 클라이언트는 MOVED 응답을 받으면 CLUSTER SLOTS(7.0부터는 CLUSTER SHARDS 권장)로 슬롯 맵을 갱신한다.
복제는 여기서도 비동기다. 고립된 Master가 write를 멈추기 전(node-timeout 이내)에 받은 write는, 승격과 함께 버려진다.
failover 관련 설정
1
2
3
4
cluster-node-timeout [ms]
cluster-replica-validity-factor [배수]
cluster-require-full-coverage [yes | no]
cluster-allow-reads-when-down [yes | no]
- cluster-node-timeout : PING 응답이 이 시간 동안 없으면 PFAIL (default 15초)
- Master가 이 시간 동안 다른 Master 과반과 연락이 안 되면, 스스로 write를 멈춘다.
- cluster-replica-validity-factor : Replica가 Master와 끊긴 지 (node-timeout x 이 값)을 넘으면 승격 후보에서 제외 (default 10)
- 가용성 vs 데이터 손실의 트레이드오프이다. 0이면 무조건 승격한다.
- cluster-require-full-coverage : 슬롯 하나라도 담당 Master가 없으면, 모든 키 요청에 CLUSTERDOWN 에러를 반환 (default yes)
- 부분 가용을 원하면 no로 설정한다.
- cluster-allow-reads-when-down : CLUSTERDOWN 상태거나 Master가 과반과 단절되었을 때, 조회를 허용할지 결정 (default no)
- 캐시 용도면 켜는 게 유리하지만, stale read가 발생할 수 있다.
센티널 vs 클러스터
| 센티널 | 클러스터 | |
|---|---|---|
| 목적 | 고가용성(HA) | 수평 확장(샤딩), HA는 내장 |
| 데이터 분산 | 없음 (Master 한 대가 전체 데이터 보유) | 16384개 슬롯으로 여러 Master에 분산 |
| 감시 주체 | 센티널 프로세스 | 노드끼리 (gossip) |
| 장애 판정 | SDOWN → quorum 합의 → ODOWN | PFAIL → Master 과반 → FAIL |
| 승격 주체 | 리더 센티널이 지정 | Replica가 요청, Master 과반이 승인 |
| 고립된 Master | write를 계속 받음 (min-replicas-to-write 필요) | node-timeout 후 스스로 write 중단 |
| 클라이언트 디스커버리 | 센티널에 질의 | MOVED + 슬롯 맵 |
HA가 목적이면 센티널, 수평 확장이 목적이면 클러스터를 사용한다.
시리즈 정리 : 각 구성이 해결한 것과 남긴 것
| 구성 | 해결한 것 | 남은 한계 |
|---|---|---|
| 싱글 + 영속성 | 프로세스가 죽어도 데이터 복구 | 디스크를 잃으면 데이터도 잃음 |
| 레플리카 | 다른 호스트에 데이터 이중화 | failover가 수동 |
| 센티널 | failover 자동화 (HA 완성) | Master 한 대의 메모리·저장 한계 |
| 클러스터 | 샤딩으로 수평 확장 (HA 내장) | 멀티키 제약, 운영 복잡도 |
클러스터로 용량과 저장을 수평 확장했다.
하지만 멀티키 제약(CROSSSLOT), 클러스터 지원 클라이언트, 논리 DB 분리 불가, 운영 복잡도라는 대가가 따른다.
대부분의 서비스는 센티널 구성으로 충분하다. 데이터 규모와 저장 부하가 정말 Master 한 대를 넘는지 확인한 뒤에 선택할 구성이다.
Redis 아키텍처 시리즈
- 싱글 구성과 영속성 (RDB, AOF)
- 레플리카 (Replication)
- 센티널 (Sentinel)
- 클러스터 (Cluster)
This post is licensed under CC BY 4.0 by the author.