Redis 레플리카 (Replication)
Redis 레플리카 (Replication)
레플리카 구성
Master의 데이터를 다른 호스트의 Replica에 복제해두는 구성
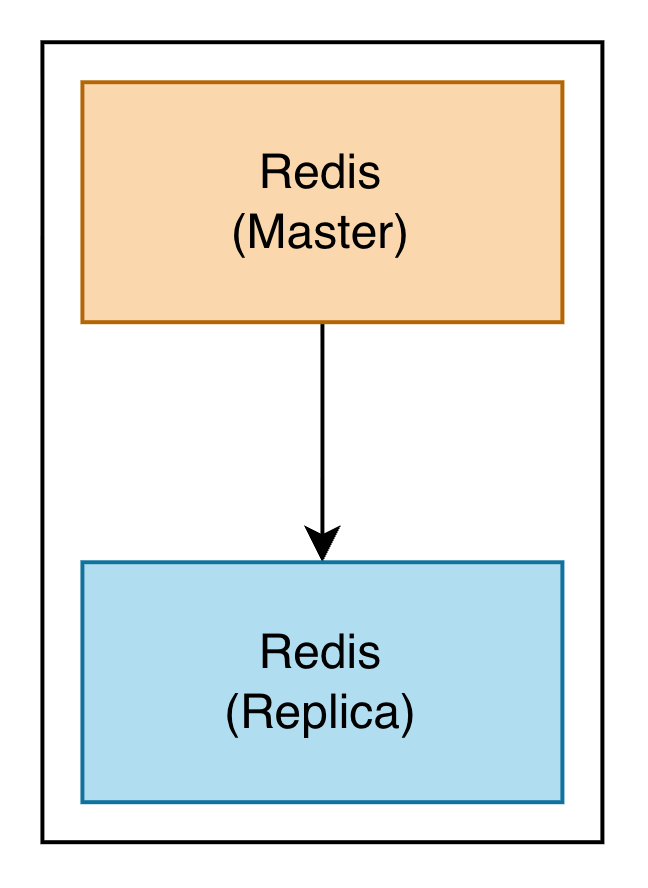
- Master의 디스크를 잃어도 Replica에 데이터가 남아 있다.
복제 시작 과정
Replica의 redis.conf에 Master 정보를 설정하면 복제 시작
1
replicaof [Master IP] [Master Port]
- Replica가 Master에 TCP connect
- PING → AUTH → REPLCONF listening-port [포트] 순서로 자신을 Master에 등록한다. (Master의 INFO replication에 slave로 표시된다)
- PSYNC ? -1 을 보내면 Master가 +FULLRESYNC로 응답하고, fork로 RDB를 생성해 전송한다.
- 그동안 들어온 write는 Master가 버퍼에 쌓아둔다.
- Replica는 기존 데이터를 비우고 RDB를 로드한 뒤, 버퍼의 write를 이어서 받는다.
저장과 조회
저장은 Master, 조회는 Master와 Replica
- 노드의 역할(role)이 받을 수 있는 요청을 결정한다. Master는 RW(저장·조회 모두), Replica는 기본 RO(조회 전용,
replica-read-only yes)이다. - 저장 : Master가 처리하고, 복제 스트림으로 Replica에 전파한다.
- 최초 동기화가 끝나면, 동일한 TCP 연결이 복제 모드로 전환된다.
- Master가 write 명령 스트림을 push 한다. (Replica가 요청하지 않아도 수신)
- Replica는 REPLCONF ACK [offset] 으로 수신 위치를 주기적으로 보고한다.
- 조회 : 기본은 Master가 처리하지만, 클라이언트 설정으로 Replica에 분산할 수 있다.
- 복제는 비동기라서, Replica 조회는 복제 지연만큼 과거 데이터를 읽을 수 있다. (stale read)
재연결 시 동기화
Replica 재연결 시, 전체 데이터가 아닌 증분만 받아 동기화하는 방식
1
PSYNC [replid] [offset]
- replid가 Master의 것과 일치하고, 끊긴 위치가 Master의 backlog 안에 있으면 partial sync로 그 이후만 받는다.
- replid가 다르거나 backlog를 벗어났으면 full sync로 RDB를 처음부터 다시 받는다.
복제와 영속성의 역할 차이
복제는 노드 하나의 장애에 대비, 영속성은 전 노드 동시 장애에 대비
- 전 노드가 동시에 재시작되면(정전 등) 메모리의 사본은 모두 사라진다. 디스크에 남은 RDB/AOF만이 복구 수단이다.
- 잘못된 명령도 그대로 복제된다. Master에서 FLUSHALL을 실행하면 Replica의 데이터도 함께 사라진다.
- 이 경우 RDB 백업으로 해당 시점의 데이터 복구가 가능하다.
- 함정 : 영속성 없는 Master가 자동 재기동되면 빈 데이터셋으로 뜨고, Replica들이 그것을 복제해서 전부 비워진다.
- 재시작 후에도 partial sync가 가능하려면, replid/offset이 RDB에 저장되어 있어야 한다.
장애 발생과 대응
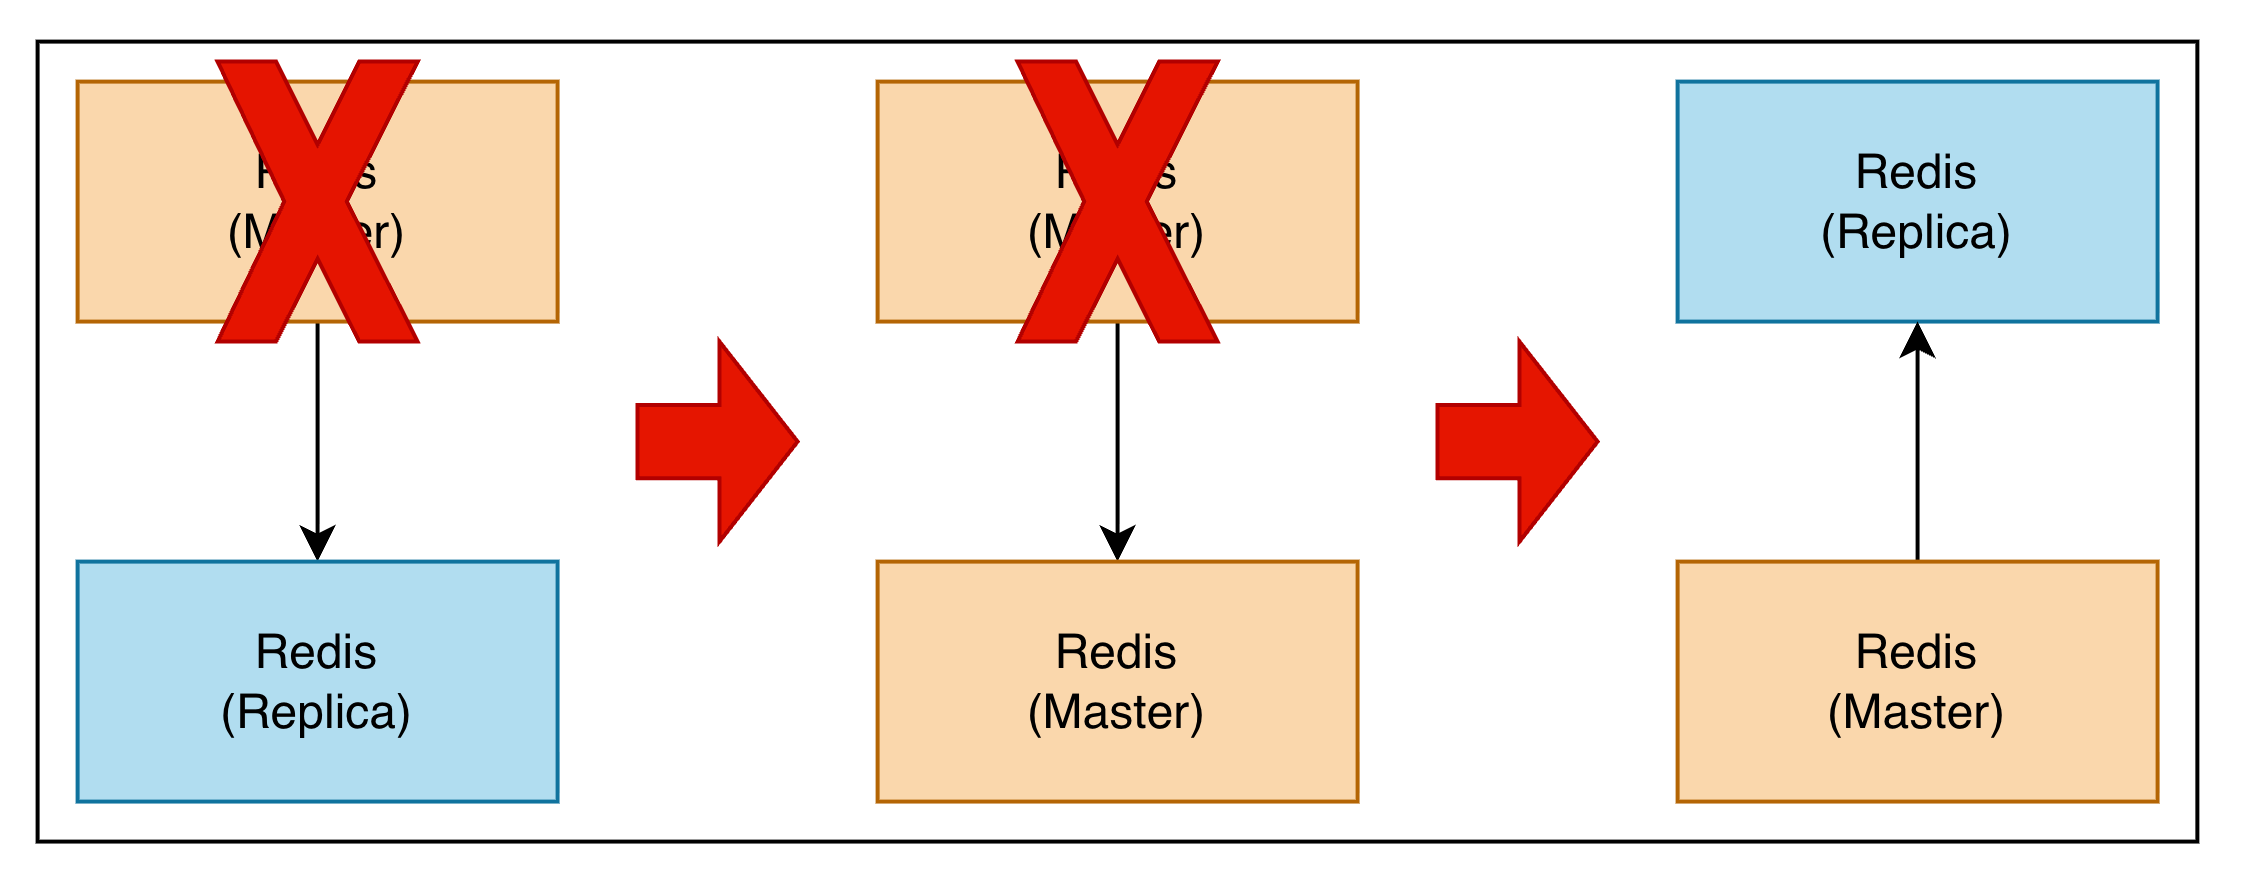
Master가 죽으면 수동으로 failover 필요
- 모니터링/알람으로 장애를 인지한다.
- Replica를 Master로 승격한다. (REPLICAOF NO ONE, Replica가 여러 대면 offset이 가장 큰 것을 고른다)
- 복제 구성을 다시 잡는다. (되살아난 옛 Master는 Replica로 강등해야 Master가 둘이 되는 것을 막는다)
- 클라이언트에서 Master 주소를 재설정한다.
사람이 개입해야 하므로, failover 자동화가 필요하다.
복제는 비동기라서, Master가 응답했지만 아직 Replica에 전달되지 않은 write는 승격 시 유실된다.
Replica가 스스로 승격하지 못하는 이유
Replica는 Master가 죽은 것인지, 자신의 네트워크가 끊긴 것인지 구분하지 못한다. 이 상태에서 스스로 승격해버리면, 살아 있는 Master가 write를 받는 동안 새 Master도 write를 받아 서로 다른 데이터가 쌓인다. (split-brain)
그래서 승격 판정은 외부에서 여럿이 합의해서 내려야 한다.
관련 설정
1
2
3
repl-backlog-size [크기]
min-replicas-to-write [개수]
min-replicas-max-lag [초]
- repl-backlog-size : partial sync에 사용하는 backlog 버퍼 크기 (default 1MB)
- 끊김이 잦거나 write가 많으면, 키워서 full sync 발생을 줄인다.
- min-replicas-to-write : 지연이 max-lag 이내인 Replica가 이 수보다 적으면, Master가 write를 거부한다. (default 0, 비활성)
- min-replicas-max-lag(default 10초)와 짝으로 동작한다.
- 고립된 Master가 혼자 write를 계속 받는 것을 막아, split-brain 피해를 줄이는 안전장치이다.
- 대가가 있다 : Replica 장애가 Master의 write 장애로 번진다.
레플리카를 이용하면 디스크를 잃어도 데이터를 복구할 수 있다.
하지만 Master가 죽은 새벽 3시에, 승격은 누가 할까?
다음 편에서는 감시와 합의로 failover를 자동화해 이 한계를 해결하는 센티널을 다룬다.
Redis 아키텍처 시리즈
- 싱글 구성과 영속성 (RDB, AOF)
- 레플리카 (Replication)
- 센티널 (Sentinel)
- 클러스터 (Cluster)
This post is licensed under CC BY 4.0 by the author.