인덱스 유형 이해하기 (Composite, Covering, Unique, Filtered)
PostgreSQL 16에서 복합·커버링·고유·필터링 인덱스를 직접 만들어 실행 계획과 실행 시간을 비교한 기록
인덱스와 실험 환경
인덱스는 테이블의 모든 행을 스캔하지 않고도 원하는 데이터에 이르는 경로를 제공해 조회 속도를 높이는 자료구조
- 이 글에서는 복합(Composite), 커버링(Covering), 고유(Unique), 필터링(Filtered) 네 가지 인덱스를 다룬다.
- 유형마다 정의와 예시를 적고, 인덱스를 적용했을 때와 하지 않았을 때를 EXPLAIN ANALYZE로 직접 비교한다.
- 실험 환경 : Docker Compose로 띄운 PostgreSQL 16이다. 필터링 인덱스는 MySQL이 지원하지 않아 PostgreSQL을 골랐다.
- 측정 방식 : 첫 실행은 디스크 캐시가 비어 있어 느리게 나오므로, 같은 스크립트를 두 번 실행해 두 번째 수치를 기록했다. 수치는 환경에 따라 달라지므로 상대 비교가 핵심이다.
| 테이블 | 행 수 | 용도 |
|---|---|---|
| members | 100만 | 복합·커버링 실험. 성 10종 × 이름 20종 × 지역 100개 |
| users | 50만 | 고유 인덱스 실험. email에 인덱스를 만들지 않은 상태에서 시작 |
| products | 100만 | 필터링 실험. status 분포는 판매중 5%, 품절 90%, 단종 5% |
같은 쿼리를 인덱스 상태만 바꿔가며 실행해 실행 계획과 시간의 변화를 본다.
복합 인덱스 (Composite Index)
둘 이상의 열을 하나의 인덱스 키로 묶은 인덱스
- 동의어는 다중 열 인덱스(multi-column index), 연결 인덱스(concatenated index)다.
- 핵심은 정렬 방식이다. 첫 번째 열로 먼저 정렬되고, 값이 같을 때 두 번째 열로 정렬된다. 성으로 먼저 정렬되고 같은 성 안에서 이름으로 정렬된 전화번호부와 같다.
회원 테이블에서 성과 이름으로 함께 조회하는 쿼리가 자주 실행된다고 가정하면, 두 열에 각각 단일 인덱스를 만드는 대신 복합 인덱스 하나를 만든다.
1
2
CREATE INDEX idx_members_name
ON members (last_name, first_name);
WHERE last_name = '조' AND first_name = '영서': 인덱스를 탄다.WHERE last_name = '조': 인덱스를 탄다. 선두 열만으로도 정렬이 유효하다.WHERE first_name = '영서': 인덱스를 타지 못한다. 인덱스가 last_name으로 먼저 정렬되어 있으므로, 성을 모른 채 이름만으로 찾으려면 전체를 훑어야 한다.- 복합 인덱스는 왼쪽 열부터 연속된 조합에만 유효하며, 이를 Leftmost Prefix 원칙이라 한다.
활용 방안
- 여러 열로 함께 필터링하거나 정렬하는 쿼리가 반복될 때 사용한다.
- 데이터를 가장 많이 좁혀주는(카디널리티 높은) 열을 앞에 둔다. 단독으로도 자주 조회되는 열을 선두에 두면 인덱스 하나로 더 많은 쿼리를 커버할 수 있다.
- 열이 많아질수록 인덱스 크기와 write 비용이 늘어난다.
직접 확인해보기 : 성 10종 × 이름 20종으로 구성된 100만 행의 members 테이블에서 같은 쿼리를 인덱스 상태만 바꿔가며 실행한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
CREATE TABLE members (
    id          bigserial PRIMARY KEY,
    last_name   text NOT NULL,
    first_name  text NOT NULL,
    city        text NOT NULL,
    created_at  timestamptz NOT NULL DEFAULT now()
);

INSERT INTO members (last_name, first_name, city)
SELECT
    (ARRAY['김','이','박','조','최','정','강','윤','장','임'])[1 + floor(random() * 10)::int],
    (ARRAY['영서','민준','서연','도윤','하늘','지우','서준','민수','예은','시우',
           '지호','수아','은우','채원','현우','유나','건우','소율','우진','다은'])[1 + floor(random() * 20)::int],
    (ARRAY['서울','부산','인천','대구','대전','광주','수원','울산','창원','고양'])[1 + floor(random() * 10)::int]
    || ' ' ||
    (ARRAY['중구','동구','서구','남구','북구','강남구','강서구','성산구','팔달구','일산구'])[1 + floor(random() * 10)::int]
FROM generate_series(1, 1000000);
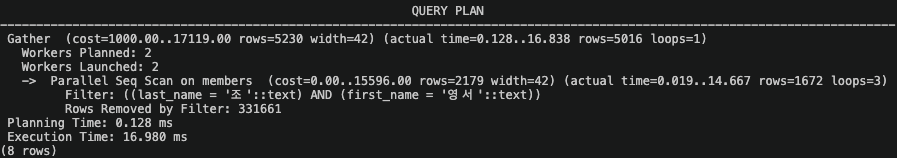
- 인덱스 없음
1
2
EXPLAIN ANALYZE
SELECT * FROM members WHERE last_name = '조' AND first_name = '영서';
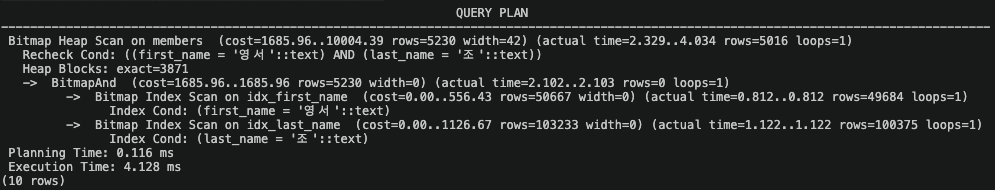
- 단일 인덱스 2개
1
2
3
4
5
CREATE INDEX idx_last_name  ON members (last_name);
CREATE INDEX idx_first_name ON members (first_name);

EXPLAIN ANALYZE
SELECT * FROM members WHERE last_name = '조' AND first_name = '영서';
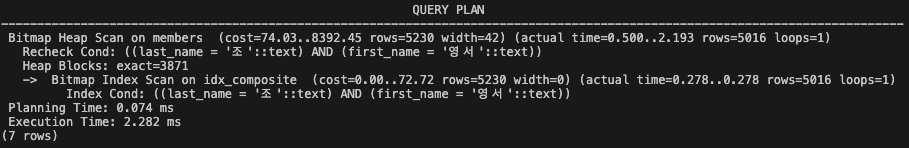
- 복합 인덱스
1
2
3
4
CREATE INDEX idx_composite ON members (last_name, first_name);

EXPLAIN ANALYZE
SELECT * FROM members WHERE last_name = '조' AND first_name = '영서';
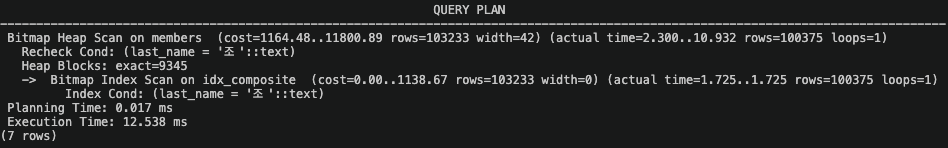
- Leftmost Prefix : 선두 열(last_name) 단독
1
2
EXPLAIN ANALYZE
SELECT * FROM members WHERE last_name = '조';
- Leftmost Prefix : 후행 열(first_name) 단독
1
2
EXPLAIN ANALYZE
SELECT * FROM members WHERE first_name = '영서';
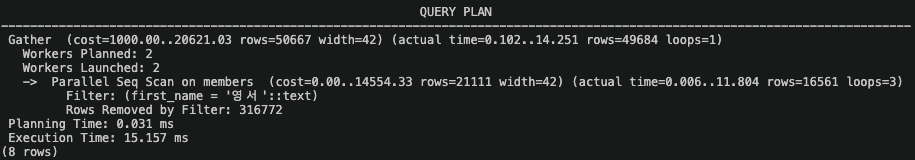
| 단계 | 인덱스 상태 | 스캔 방식 | 실행 시간 |
|---|---|---|---|
| 1 | 없음 | Parallel Seq Scan | 16.980ms |
| 2 | 단일 인덱스 2개 | BitmapAnd (Bitmap Index Scan × 2) | 4.128ms |
| 3 | 복합 인덱스 | Bitmap Index Scan | 2.282ms |
| 4 | 복합 인덱스, 선두 열만 조회 | Bitmap Index Scan | 12.538ms |
| 5 | 복합 인덱스, 후행 열만 조회 | Parallel Seq Scan | 15.157ms |
- 3단계와 5단계는 같은 인덱스가 있는 상태다. 쿼리가 선두 열을 포함하느냐에 따라 인덱스 사용 여부가 갈린다.
- 4단계는 인덱스를 탔는데도 5단계와 시간이 비슷하다. 성 하나가 전체의 10분의 1인 약 10만 행에 해당하므로, 인덱스로 찾은 뒤 테이블에서 읽어야 할 행이 많아 순차 스캔과 비용 차이가 작기 때문이다. 인덱스는 결과를 충분히 좁힐 때 효과가 난다.
복합 인덱스는 열 순서가 전부이고, 선두 열 없이는 인덱스가 없는 것과 같다.
커버링 인덱스 (Covering Index)
쿼리의 SELECT, WHERE, JOIN 절에서 참조하는 모든 열이 하나의 인덱스에 포함된 인덱스
- 비클러스터형 인덱스는 데이터 행과 분리되어 있어, 데이터 접근에 최소 두 번의 디스크 조회가 필요하다. 인덱스를 읽고 테이블을 읽는다.
- 커버링 인덱스는 필요한 정보가 모두 인덱스 안에 있으므로 두 번째 테이블 접근을 제거한다.
- 복합 인덱스가 WHERE 조건을 커버했다면, 커버링 인덱스는 SELECT 결과까지 커버한다.
회원 테이블에서 도시로 성과 이름을 조회하는 쿼리가 실행된다고 가정하면, WHERE의 city와 SELECT의 last_name, first_name을 모두 포함하는 인덱스를 만든다.
1
2
CREATE INDEX idx_members_covering
ON members (city, last_name, first_name);
- 이제 테이블에 접근하지 않고 인덱스만으로 결과를 반환한다. 서울 거주 회원이 수만 명이라면, 행마다 발생했을 테이블 접근이 전부 사라진다.
활용 방안
- 큰 테이블에서 반환하는 열은 적지만 다루는 행이 많은 쿼리에 가장 효과적이다.
- 열 구성이 안정적인 핵심 조회 쿼리(목록 조회, 요약 화면)에 적용할 가치가 있다.
- 커버 범위를 늘리려고 열을 계속 추가하면 인덱스가 비대해지고 write 성능이 나빠진다. 모든 쿼리를 커버하는 만능 인덱스가 아니라 가장 중요한 쿼리를 커버하는 인덱스다.
직접 확인해보기 : members 테이블 100만 행 중 city = '서울 강남구'가 약 1만 행이다. 일반 인덱스와 커버링 인덱스로 같은 쿼리를 실행해 테이블 접근(Heap Fetch) 유무를 비교한다.
- 단일 인덱스
1
2
3
4
CREATE INDEX idx_city ON members (city);

EXPLAIN ANALYZE
SELECT last_name, first_name FROM members WHERE city = '서울 강남구';
- 커버링 인덱스
1
2
3
4
5
CREATE INDEX idx_members_covering
ON members (city, last_name, first_name);

EXPLAIN ANALYZE
SELECT last_name, first_name FROM members WHERE city = '서울 강남구';
- 인덱스에 없는 열 요청
1
2
EXPLAIN ANALYZE
SELECT * FROM members WHERE city = '서울 강남구';
| 단계 | 인덱스 상태 | 스캔 방식 | 실행 시간 |
|---|---|---|---|
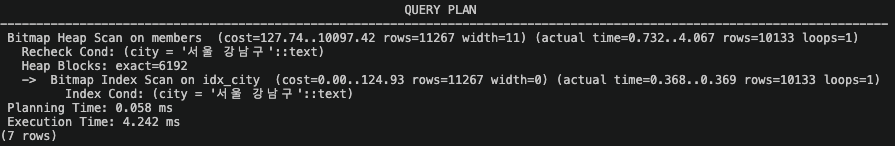
| 1 | 단일 인덱스 (city) | Bitmap Index Scan + Heap 접근 | 4.242ms |
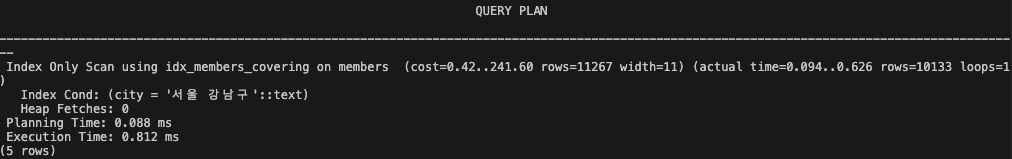
| 2 | 커버링 인덱스 | Index Only Scan (Heap Fetches: 0) | 0.812ms |
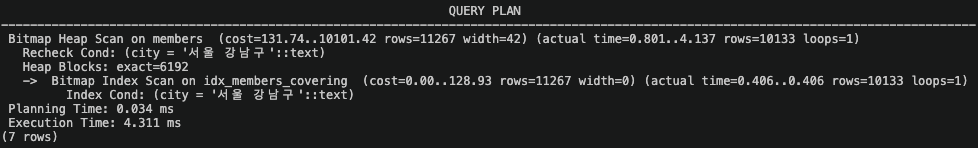
| 3 | 커버링 인덱스, SELECT * | Bitmap Index Scan + Heap 접근 | 4.311ms |
- 2단계의 Heap Fetches: 0이 커버링의 증거다. 1만 행을 반환하면서 테이블을 한 번도 읽지 않았다.
- 3단계는 같은 인덱스가 있어도 SELECT 열이 인덱스 밖에 있으면 다시 테이블 접근이 생긴다. 커버링은 인덱스의 속성이 아니라 인덱스와 쿼리의 관계다.
커버링 인덱스는 테이블 접근을 제거하고, 그 효과는 쿼리가 요청하는 열이 인덱스 안에 있을 때만 난다.
고유 인덱스 (Unique Index)
인덱스 키 값의 중복을 허용하지 않는 인덱스
- 동일한 값을 만드는 레코드를 삽입하려 하면 데이터베이스가 차단한다.
- 조회 속도를 높이는 성능 도구이면서, 동시에 중복을 원천 차단하는 데이터 무결성 도구라는 이중 역할이 특징이다.
1
2
3
4
5
CREATE UNIQUE INDEX idx_users_email
ON users (email);

INSERT INTO users (email, name) VALUES ('youngseo@naver.com', '조영서');
-- ERROR: duplicate key value violates unique constraint
활용 방안
- 유일해야 하는 값(이메일, 휴대폰 번호, 사업자등록번호, 주문번호)에 사용한다. 이런 값의 중복은 성능 문제가 아니라 데이터 정합성 사고다.
- 조회해서 없으면 삽입하는 애플리케이션 로직은 두 요청이 동시에 들어오면 뚫린다. 둘 다 조회 시점에는 중복이 없다고 판단하기 때문이다. 고유 인덱스는 이 경우에도 중복을 확실히 차단한다.
- NULL 처리는 DB마다 다르다. PostgreSQL은 default로 NULL끼리 중복으로 보지 않아 NULL이 여러 행에 존재할 수 있다.
직접 확인해보기 : users 테이블 50만 행, email에 인덱스가 없는 상태에서 중복 데이터가 들어가는지, 차단되는지 확인한다.
1
2
3
4
5
6
7
8
9
10
11
CREATE TABLE users (
    id     bigserial PRIMARY KEY,
    email  text NOT NULL,
    name   text NOT NULL
);

INSERT INTO users (email, name)
SELECT 'user' || g || '@example.com', '회원' || g
FROM generate_series(1, 500000) g;

INSERT INTO users (email, name) VALUES ('youngseo@naver.com', '조영서');
- 고유 인덱스 없음
1
2
3
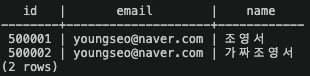
INSERT INTO users (email, name) VALUES ('youngseo@naver.com', '가짜조영서');

SELECT id, email, name FROM users WHERE email = 'youngseo@naver.com';
- 고유 인덱스 : 정합성
1
2
3
CREATE UNIQUE INDEX uq_users_email ON users (email);

INSERT INTO users (email, name) VALUES ('youngseo@naver.com', '가짜조영서');

- 고유 인덱스 : 성능
1
2
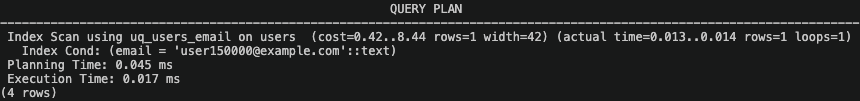
EXPLAIN ANALYZE
SELECT * FROM users WHERE email = 'user250000@example.com';
| 단계 | 인덱스 상태 | 결과 |
|---|---|---|
| 1 | 없음 | 같은 이메일이 2행 저장된다 |
| 2 | 고유 인덱스 | INSERT가 duplicate key 오류로 거부된다 |
| 3 | 고유 인덱스 | Index Scan, 0.017ms |
- 고유 인덱스는 다른 유형과 달리 실행 시간이 아니라 상황이 갈린다. 없으면 중복이 조용히 들어가고, 있으면 DB가 거부한다.
- 3단계의 0.017ms는 고유 인덱스도 일반 B-Tree 인덱스이므로 조회 성능까지 함께 얻는다는 뜻이다.
고유 인덱스는 애플리케이션이 놓친 중복을 DB 레벨에서 막는 마지막 방어선이다.
필터링 인덱스 (Filtered Index)
특정 조건을 만족하는 행의 부분 집합만 인덱싱하는 인덱스
- 동의어는 부분 인덱스(partial index), 조건부 인덱스(conditional index)다.
- 수백만 건의 상품 테이블에서 조회의 대부분이 판매 중인 상품만 대상으로 한다면, 판매 중인 행만 인덱싱한다.
1
CREATE INDEX idx_products_on_sale ON products (price) WHERE status = '판매중';
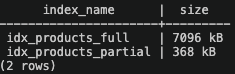
- 전체 상품 중 판매 중인 상품이 5%뿐이라면, 인덱스 크기는 전체 인덱싱 대비 약 20분의 1이 된다.
- 인덱스가 작을수록 적은 디스크 조회로 탐색이 끝나고, 메모리에 올라갈 가능성도 높아진다.
- 품절 상품이 삽입되거나 갱신될 때 이 인덱스를 건드릴 필요가 없다는 것도 이득이다.
활용 방안
- 데이터가 특정 값에 치우쳐 있고, 쿼리도 해당 부분 집합만 노리는 경우에 강력하다.
- 미처리 주문만 조회하는 큐 성격의 테이블 :
WHERE status = 'PENDING' - 탈퇴하지 않은 회원만 조회 :
WHERE deleted_at IS NULL - 판매 중인 상품만 노출 :
WHERE status = '판매중'
- 미처리 주문만 조회하는 큐 성격의 테이블 :
- 쿼리의 WHERE 조건이 인덱스의 필터 조건을 포함해야 옵티마이저가 이 인덱스를 사용한다.
- PostgreSQL과 SQL Server는 지원하지만 MySQL은 지원하지 않는다.
직접 확인해보기 : products 테이블 100만 행, status 분포는 판매중 5%, 품절 90%, 단종 5%다. 전체 인덱스와 필터링 인덱스를 나란히 만들어 크기, 조회, write 세 가지를 비교한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
CREATE TABLE products (
    id        bigserial PRIMARY KEY,
    category  text NOT NULL,
    price     int  NOT NULL,
    status    text NOT NULL
);

INSERT INTO products (category, price, status)
SELECT
    (ARRAY['가전','의류','식품','도서','뷰티','스포츠','완구','가구'])[1 + floor(random() * 8)::int],
    (1 + floor(random() * 1000)::int) * 1000,
    CASE
        WHEN r < 0.05 THEN '판매중'   -- 5%
        WHEN r < 0.95 THEN '품절'     -- 90%
        ELSE               '단종'     -- 5%
    END
FROM (SELECT random() AS r FROM generate_series(1, 1000000)) t;
- 인덱스 크기 비교
1
2
3
4
5
6
7
CREATE INDEX idx_products_full    ON products (price);
CREATE INDEX idx_products_partial ON products (price) WHERE status = '판매중';

SELECT relname AS index_name,
       pg_size_pretty(pg_relation_size(oid)) AS size
FROM pg_class
WHERE relname IN ('idx_products_full', 'idx_products_partial');
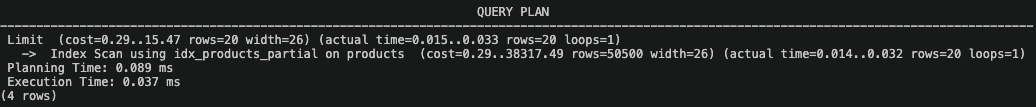
- 필터링 인덱스 : 필터 조건을 포함한 조회
1
2
3
4
EXPLAIN ANALYZE
SELECT * FROM products
WHERE status = '판매중'
ORDER BY price LIMIT 20;
- 필터링 인덱스 : 필터 조건 밖의 조회
1
2
3
4
EXPLAIN ANALYZE
SELECT * FROM products
WHERE status = '품절'
ORDER BY price LIMIT 20;
- write 비용 : 전체 인덱스
1
2
3
EXPLAIN ANALYZE
UPDATE products SET price = price + 1000
WHERE status = '품절' AND id <= 100000;
- write 비용 : 필터링 인덱스
1
2
3
EXPLAIN ANALYZE
UPDATE products SET price = price + 1000
WHERE status = '품절' AND id <= 100000;
| 단계 | 비교 항목 | 전체 인덱스 | 필터링 인덱스 |
|---|---|---|---|
| 1 | 인덱스 크기 | 7096 kB | 368 kB |
| 2 | 판매중 조회 | Index Scan, 0.037ms | |
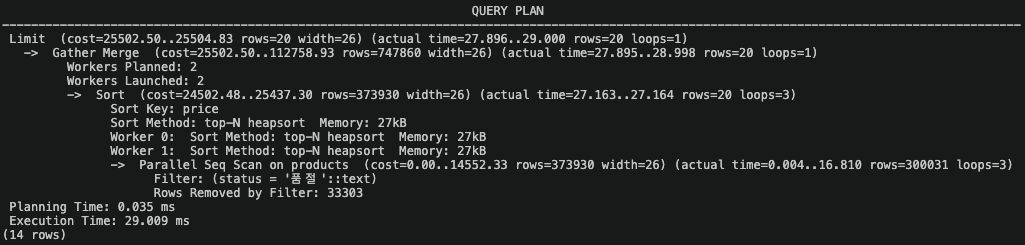
| 3 | 품절 조회 | Parallel Seq Scan, 29.009ms | |
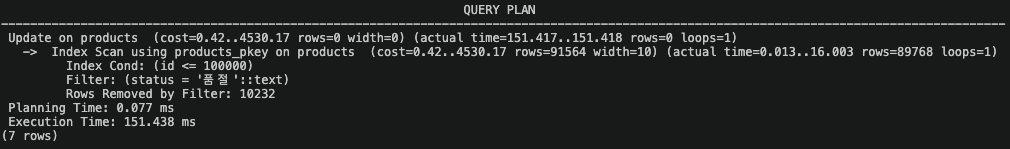
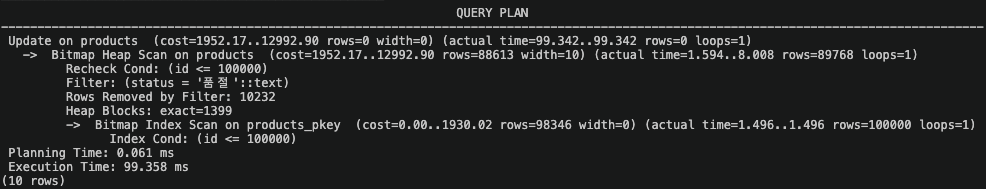
| 4, 5 | 품절 10만 행 UPDATE | 151.438ms | 99.358ms |
- 크기는 약 19분의 1로, 판매중 비율 5%에서 예상한 20분의 1과 맞는다.
- 3단계는 필터 조건 밖의 쿼리라 인덱스를 아예 쓰지 못한다. 필터링 인덱스는 필터 안의 쿼리만 빠르게 만든다.
- 4단계와 5단계는 품절 행만 갱신하므로 필터링 인덱스는 갱신 대상이 없다. 전체 인덱스는 10만 건의 인덱스 항목을 모두 갱신해야 한다.
필터링 인덱스의 이득은 크기, 조회, write 세 겹이고, 그 대가로 필터 밖의 쿼리에는 아무 도움도 주지 않는다.
네 가지 인덱스 비교
| 인덱스 | 한 줄 요약 | 핵심 활용 시점 |
|---|---|---|
| Composite | 여러 열을 하나의 키로 묶는다 | 다중 열 필터·정렬 쿼리가 반복될 때 (열 순서 주의) |
| Covering | 인덱스만으로 쿼리를 끝낸다 | 적은 열을 반환하지만 많은 행을 다루는 쿼리 |
| Unique | 중복을 DB 레벨에서 차단한다 | 유일해야 하는 값의 무결성 보장 |
| Filtered | 데이터의 일부만 인덱싱한다 | 치우친 데이터의 특정 부분집합만 조회할 때 |
인덱스는 종류가 아니라 쿼리와의 관계로 효과가 결정되므로, 어떤 쿼리를 빠르게 할지부터 정해야 한다.