4가지 캐시 구성 부하 실험
네 가지 캐시 구성을 75회 부하 실험으로 비교했다. 응답 지연보다 DB 로딩과 콜드 스타트에서 차이가 났고, 현재 조건에서 Redis 도입을 기각했다.
실험 환경
앞 편에서 정한 지표를 로컬 Docker Compose 환경에서 부하 run 75회로 측정
- 앞 편에서 인프로세스 캐시가 공유되지 않는다는 사실만으로 공유 캐시가 정당화되지는 않는다고 정리하고, 무엇을 재야 하는지 적었다. 이 글은 그 뒤에 진행한 실험 기록이다.
- 실험은 Redis를 넣으려고 시작했고, 끝났을 때 Redis를 빼기로 결정했다. 처음 세운 가설은 대부분 기각됐고, 공유 캐시가 콜드 스타트에서 DB를 보호한다는 예상도 반대로 나왔다.
- 구성 : nginx 라운드로빈 + 조회 API 4대(각 1 CPU/768MB) + 전용 PostgreSQL(2 CPU) + Redis 7(maxmemory 1GB, persistence off), Prometheus 5초 스크레이프
- 캐시 : L1 Caffeine TTL 2초, L2 Redis TTL 3초
- 비교 대상 : 캐시 없음, 인프로세스만, 공유 캐시만, 2계층(L1 + L2)
- 부하 발생기 : k6
측정 환경은 로컬 Docker Compose(Apple M5 Pro)이며 부하 발생기와 서버가 같은 머신에서 돌았다. 따라서 아래 수치는 운영 환경의 절대 용량이 아니라 전략 간 비교 기준이다.
수치는 절대 용량이 아니라 전략 간 비교 기준이다.
임계점 탐색과 표기 규율
목표 부하 10,000 rps 대신 장비의 임계점을 먼저 탐색
- 목표로 둔 시나리오는 인기 종목 급등 시 10초간 10만 요청, 즉 10,000 rps였다. 이 장비는 그 부하를 만들지 못했다.
- 단계별로 요청률을 올려 임계점을 먼저 찾았다. 1대 구성은 1,600~2,000 rps, 4대 구성은 2,800~3,200 rps에서 임계점이 왔고 포화 실효 처리율은 약 5,700 rps였다.
- 부하 발생기가 서버와 자원을 나눠 쓰는 환경이므로 이 위쪽은 무엇을 측정하든 발생기 병목과 섞인다.
- 표기 규율 : 10만 사용자를 처리했다고 쓰지 않고, 로컬 Compose 환경에서 최대 약 5.7k rps까지 검증했다고 쓴다.
- 전략 비교는 1대 구성까지 무결하게 따라오는 공통 요청률 1,600 rps에서 수행했다. 한 구성이 이미 포화된 지점에서 비교하면 캐시 전략의 차이가 아니라 포화 순서를 재게 된다.
- 조회 경로 비교를 위해 감사 기록과 요청 메트릭의 동기 INSERT를 부하 프로필에서만 껐다. 캐시 효과와 INSERT 병목이 섞이는 것을 막기 위한 분리이며, default 프로필의 계약은 유지했다.
전략 비교는 모든 구성이 포화되지 않는 공통 요청률에서 해야 한다.
응답 지연과 DB 로딩 비교
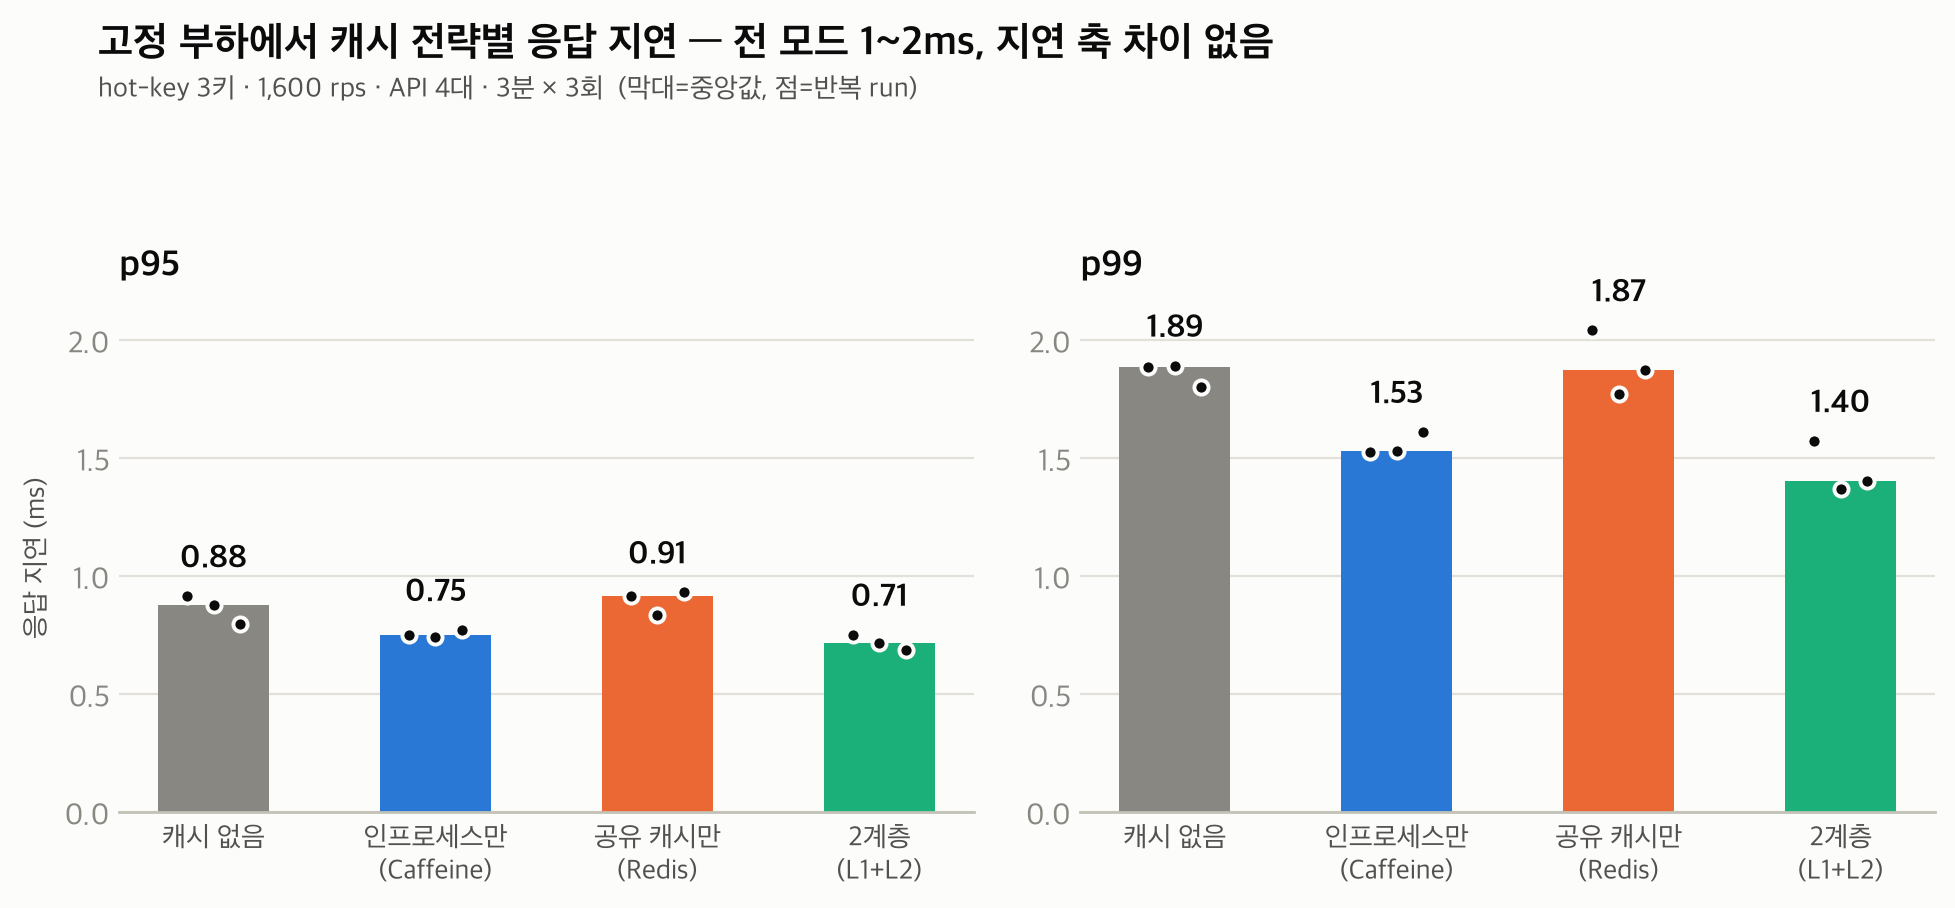
1,600 rps, 3분, 3회 반복 중앙값 기준의 네 전략 비교
| 모드 | API 수 | p99 | DB loader 호출(3분) |
|---|---|---|---|
| 캐시 없음 | 1 | 1.4ms | 287,998 |
| 인프로세스만 | 1 | 1.1ms | 268 |
| 캐시 없음 | 4 | 1.9ms | 287,997 |
| 인프로세스만 | 4 | 1.5ms | 1,062 |
| 공유 캐시만 | 4 | 1.9ms | 192 |
| 2계층 | 4 | 1.4ms | 146 |
- L1 적중률은 99.6~99.9%였고 전 모드에서 오류는 0이었다.
- p99는 캐시가 아예 없는 구성까지 전부 1~2ms 안에 들어온다. 이 요청률에서는 DB 조회 자체가 충분히 싸서, 캐시 유무가 응답 지연에 드러나지 않았다.
- 적중률 99.9%와 p99 1.5ms를 나란히 두면 캐시가 응답을 빠르게 만든 것처럼 읽히지만, 대조군인 캐시 없음도 1.9ms다. 앞 편에서 히트율만으로는 결정할 수 없다고 적은 이유가 이 표에 그대로 있다.
- loader 축을 보면 차이는 분명하다. 288,000건의 요청이 4대 인프로세스 구성에서 1,062회의 DB 로딩으로 접혔다. 이 값은 이론치(키 3종 × TTL 주기 90 × 4대)의 0.98배다.
- 요청 수에 비례하던 것이 인스턴스 수에 비례하는 상수로 바뀌었다는 뜻이며, 앞 편의 정의대로 이것은 스탬피드가 아니다.
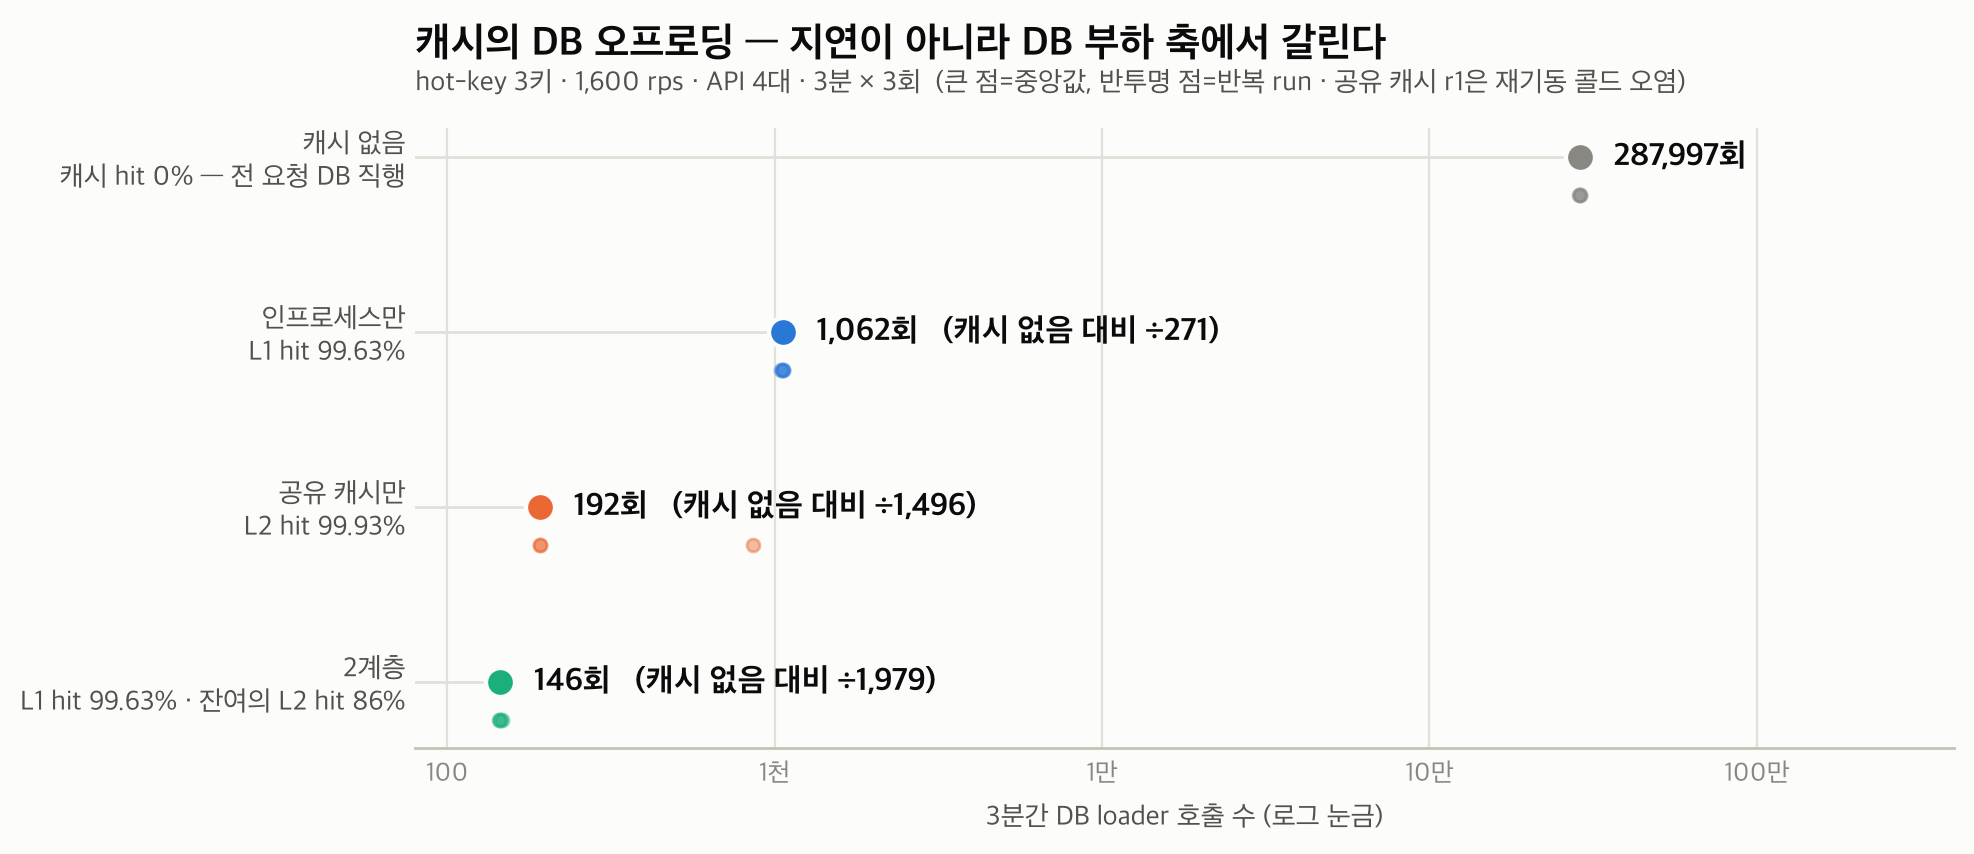
- 공유 캐시는 DB 로딩을 1,062회에서 192회로 더 줄였다. 초당으로는 5.9회에서 1.1회다.
- 같은 시간 PostgreSQL은 초당 약 4,800 트랜잭션을 처리하고 있었고 커넥션 풀 대기는 0이었다. 여유가 3배 남은 자원에서 아끼는 양은 초당 4.8회였다.
네 전략의 응답 지연은 서로 구별되지 않았고, 차이는 DB loader 축에서만 보였다.
콜드 스타트
모든 캐시를 비우고 재기동한 직후 30초간의 DB loader 호출 측정
| 모드 | 30초간 loader 호출 | 초당 피크 |
|---|---|---|
| 인프로세스만 | 92 | 5.7 |
| 공유 캐시만 | 1,658 | 85 |
| 2계층 | 17 | 1.0 |
- 예상은 공유 캐시가 콜드 스타트의 DB 피크를 흡수한다는 것이었다. 결과는 반대였다.
- 공유 캐시 단독 구성이 인프로세스만 쓰는 구성보다 18배 많은 DB 로딩을 냈다. 이 실험에서 관측한 유일한 진짜 스탬피드이며, 요청 수에 비례하는 폭증이라는 정의를 만족한다.
- 원인은 첫 로딩의 소요 시간이다. 캐시가 완전히 빈 상태의 DB 조회는 수백 ms가 걸린다. 그 사이에도 1,600 rps는 계속 도착하고, 공유 캐시 경로에는 도착한 요청을 하나의 로딩으로 합칠 장치가 없어 전부 DB로 흘러간다.
- 2계층 구성에서는 L1 원자 로더가 동시 miss를 한 번의 로딩으로 합쳤고, DB 로딩은 17건에 그쳤다.
콜드 스타트에서 DB를 가장 세게 때린 것은 공유 캐시 단독 구성이었다.
공유 캐시로 옮기며 놓친 single-flight
콜드 스타트 결과는 Redis의 성질이 아니라 요청 병합을 구현하지 않은 구현 선택의 성질
- 분산 락이나 인스턴스 로컬 요청 병합을 얹으면 완화된다. Redis가 스탬피드에 취약하다는 뜻이 아니다.
- 문제는 캐시를 옮길 때 사라지는 보장이었다. 인프로세스 캐시에서 공유 캐시로 옮기면서 로컬 캐시가 공짜로 주던 single-flight를 잃었다.
- 이 보장은
cache.get(key, loader)한 줄에 딸려 왔고 설계 문서에는 따로 적혀 있지 않았다. 이동 체크리스트에서도 빠졌다. - 앞 편에서 single-flight의 범위를 따로 한 절로 다룬 이유다.
캐시 계층을 옮길 때는 로컬 캐시가 암묵적으로 주던 보장을 목록으로 적어야 한다.
TTL 동시 만료와 jitter
전 인스턴스의 캐시를 동시에 만료시키고 1,600 rps 버스트(9.6만 요청)를 주입
- 만료 온셋 10초 구간의 DB loader 호출은 1.5~1.8건이었다. L1 miss는 8~9건으로 이론치(키 1종 × 4대 × TTL 주기)와 일치했고, 그 miss를 L2가 받아 접었다.
- 요청 수 비례 폭증은 없었다. 동시 만료 스탬피드 가설은 기각이다.
- jitter 0과 2초를 비교했을 때 전 지표가 반복 편차 안에 들어왔다. 효과가 없었다기보다 완화할 피크가 애초에 없었다. 60초 동안 L2 재적재가 20건뿐인 상황에서는 흩뿌릴 대상이 없다.
- 앞 편에서 jitter는 동시에 만료되는 키가 여럿일 때 쓰는 장치이고 단일 hot key에는 무력하다고 적었는데, 이 시나리오는 정확히 그 조건이었다.
- 사정거리 : 이 실험의 hot key는 사실상 한 종목이다. 워킹셋이 수백 종목이고 그 키들이 같은 순간에 적재됐다면 결과가 다를 수 있으며, 그 국면은 재지 않았다.
TTL 동시 만료는 스탬피드가 아니었고, jitter는 완화할 피크를 찾지 못했다.
Redis 장애 주입
2계층 구성에서 부하 중 Redis를 60초간 정지
- 오류는 0이었고 1,600 rps는 평탄하게 유지됐다.
- DB loader는 초당 5.15회로, L1 단독 이론치인 초당 6회 수준이다. 요청률 초당 1,600 대비 310분의 1이다. L2가 사라져도 L1이 요청 수 비례 폭증을 막았다.
- 지연은 올라갔다. p99가 1.0ms에서 313~319ms가 됐는데, 이 값은 명령 타임아웃 150ms의 정확히 2배다. 요청 하나가 L2 get 실패와 put 실패를 직렬로 겪기 때문이다.
- fail-open의 지연 대가는 타임아웃 값 안에 머물렀고, 시간이 지나며 악화되는 연쇄는 없었다.
- 복귀 시 재적재 herd도 없었다. Redis가 돌아온 뒤 L2 miss는 초당 0.76회 이하로, 평시 0.85회보다 오히려 낮았다.
Redis 장애 실험에서도 DB를 지킨 것은 L1이었다.
변경 반영 시간
부하 중 새 게시와 차단을 주입해 모든 인스턴스에 반영되기까지의 시간 측정
| 변경 유형 | 2계층 | 인프로세스만(재실측) | 기준 |
|---|---|---|---|
| 새 게시 | 4.22~4.45s | 3.2~4.1s | 스테일 SLO 5s |
| 차단(제공 범위 OFF) | 0.00~0.01s | 0.00~0.01s | 즉시 |
- 본 측정은 2계층 구성에서 수행했고, 채택한 인프로세스 단독 구성은 이후 같은 조건으로 재실측해 나란히 적었다.
- 두 구성 모두 SLO 안에 들어왔다. 인프로세스 단독이 더 빨리 반영되는 것은 스테일 상한이 L1 TTL 하나로 짧기 때문이다.
- 5초라는 SLO는 L1 2초와 L2 3초의 가산 상한에서 정했다. 실측값은 이 논증과 맞았지만, 3회 반복이 모두 비슷한 TTL 위상에서 실행돼 최악 위상까지 재지는 못했다. 5초 보장은 TTL 가산 논증에 근거한다.
- 차단이 사실상 즉시인 이유는 캐시와 무관하다. 차단 판정이 캐시 앞단에 있어 요청마다 DB를 확인하므로, 차단 상태는 캐시 표면 밖에 있다.
- 앞 편에서 불변 축과 변경 축을 나눠야 한다고 적은 것이 이미 부분적으로 적용돼 있었다. 본문은 캐시하고, 가장 위험한 변경 축은 캐시하지 않는다.
차단은 캐시 표면 밖에 있고, 새 게시는 TTL 가산 상한 안에 있었다.
전체 경로 비교 (감사 기록 포함)
조회 경로에서 껐던 동기 INSERT를 되살린 상태의 비교
- 200 응답마다 감사 기록과 요청 메트릭 INSERT가 각각 한 건씩 들어간다.
- INSERT의 대가는 초당 3,200 트랜잭션 증가였고, 200당 INSERT 2건이라는 이론과 0.4% 오차로 일치한다.
- 이 증가폭은 인프로세스 구성과 2계층 구성에서 완전히 동일했다. 캐시 전략을 무엇으로 바꿔도 INSERT 병목은 그대로 남는다.
- 전체 경로에서 요청당 DB 작업이 다섯 건이라면 캐시가 지우는 것은 그중 조회 한 건이다.
| 모드 | 조회 경로 p99 | 전체 경로 p99 |
|---|---|---|
| 인프로세스만 | 1.5ms | 4.2ms |
| 2계층 | 1.4ms | 5.7~11.5ms |
- 2계층 구성에서만 꼬리가 더 나빠졌고 커넥션 풀 대기가 간헐적으로 관측됐다(pending 최대 337).
- INSERT가 커넥션을 점유하는 동안 L2 왕복이 요청 처리 시간을 늘려 겹치는 것으로 보이지만, 깨끗한 반복이 2회뿐이어서 방향만 신뢰하고 크기는 미확정으로 남긴다.
감사 기록을 되살리면 캐시 전략의 차이는 사라지고, 2계층의 지연 꼬리만 남는다.
결정과 재검토 조건
두 후보를 각각의 이유로 기각하고 인프로세스 캐시 유지
- 공유 캐시 단독 : 콜드 스타트에서 유일한 진짜 스탬피드를 만들었다. 요청 병합을 추가하면 막을 수 있지만, 그것은 인프로세스 캐시가 이미 갖고 있는 것을 다시 구현하는 일이다.
- 2계층 : 이득이 실재했다. 측정 중 4대째 인스턴스를 합류시키자, 신규 인스턴스의 L1 miss 초당 1.5회가 전부 L2 적중으로 흡수되며 클러스터 전체 DB loader가 30초당 22회로 평평했다. 인프로세스만이었다면 초당 0.8회에서 2.3회로 약 3배가 됐을 값이다.
- 역할 분담이 여기서 선명해진다. 폭발 방어는 L1의 요청 병합이 맡고, 증설분의 상시 상환은 L2가 맡는다.
- 문제는 그 이득의 절대값이 초당 1.5회라는 것이다. 대가는 전체 경로 지연 꼬리 악화, TTL 두 계층의 운영 복잡도, 새로운 공용 장애 의존성, 그리고 증권사 관리 환경에 컴포넌트를 하나 더 반입하는 절차 비용이다.
- 우리 환경에서는 여러 프로세스가 같은 값을 다시 만든다는 조건만 해당했다. 로더는 약 1ms로 쌌고 인스턴스도 4대였다.
| 재검토 트리거 | 현재 값 |
|---|---|
| 워킹셋이 수백 종목으로 확대 | 키 3종 |
| 로더가 고비용화(무거운 조립·외부 호출) | 약 1ms |
| 인스턴스가 수십 대 규모 | 4대 |
| DB가 다른 워크로드와 공유되는 자원이 됨 | 전용, 여유 3배 |
| 캐시 외 용도로 Redis가 이미 도입됨 | 없음 |
- 표의 첫 줄은 후속 측정 29회에서 숫자로 바뀌었다. 균등 접근에서 L1 적중률이 50% 아래로 내려가는 지점은 798~800종이었고, 1,088종에 요청의 90%를 인기 종목으로 몰아주자 적중률은 90.5%를 유지했다.
- 급변 시나리오에서는 요청률을 200 rps에서 4,000 rps로 올려도 DB 로딩이 초당 3.3회에서 5.8회로 늘어나는 데 그쳤다. 요청은 20배, DB 부하는 1.7배였다. 상세는 4편에 정리했다.
초당 1.5회의 이득으로 2계층의 비용 목록을 지불할 근거는 만들어지지 않았다.
실험의 한계
로컬 측정의 한계 정리
- 부하 발생기와 서버가 같은 머신이었고, 목표 10,000 rps에는 도달하지 못했다.
- 워킹셋은 사실상 단일 키였고, 전체 경로 꼬리 비교는 반복이 부족했다.
- 운영 배치 전에는 별도 부하 발생 노드에서 워킹셋을 실제 종목 수로 늘려 다시 재야 한다.
- 이 실험으로 결정을 뒤집을 조건을 숫자로 적을 수 있었다. 현재 결정을 내리기에는 그 정도면 충분했다.
앞 편에서 지표 없이는 결정할 수 없다고 적었고, 지표를 얻은 뒤 Caffeine을 유지하기로 했다.
네 가지 캐시 구성을 같은 조건에서 비교해 현재 조건의 Redis 도입을 기각했다.
그렇다면 이 결정의 근거와 뒤집을 조건을 어떻게 남겨야 다음에 판단을 반복하지 않을까?
다음 편에서는 판단 근거와 재검토 조건을 정리한 결정 기록을 다룬다.
캐시 전략 시리즈
- 다중 인스턴스와 Redis 도입 판단
- 4가지 캐시 구성 부하 실험
- Caffeine 유지 결정 기록
- 캐시 경계 측정 (워킹셋 임계점)