캐시 경계 측정 (워킹셋 임계점)
워킹셋 수백 종으로 남겨둔 재검토 조건을 직접 측정했다. L1 적중률은 798~800종에서 무너지기 시작했고, 접근 분포를 바꾸자 경계도 움직였다.
측정 배경
결정 기록의 재검토 조건 첫 줄인 워킹셋 수백 종의 범위를 숫자로 확정하기 위한 측정
- 결정 기록에서 인프로세스 캐시 단독 유지를 확정하고, 뒤집을 조건을 표로 적었다. 그 표의 첫 줄은 워킹셋이 수백 종목으로 확대되면 다시 잰다는 것이었다.
- 수백의 범위가 너무 넓어서, 이대로는 어느 시점에 캐시 구성을 다시 검토해야 할지 알 수 없었다.
- 측정 환경은 앞선 실험과 동일한 로컬 Docker Compose(API 4대, L1 TTL 2초, L2 TTL 3초, 요청률 1,600 rps)다.
- 종목 수 100·300·3,000·5,000은 2분 1회 탐색, 800·1,088 및 분포 실험은 3분 3회 반복 중앙값이다.
이 글은 캐시 전략 시리즈의 번외편으로, 재검토 조건의 경계선을 직접 측정한 기록이다.
가설 : TTL 내 도달 횟수
측정 전에 가설과 기각 조건을 먼저 기록
- 결과를 보고 나서 설명을 만들지 않기 위해서다.
- 메모리 부족 가능성부터 계산했다. 5,000종 × 값 1.5KB × 4대는 약 30MB이고,
maximumSize10,000 안에 들어온다. 이 조건에서는 메모리와 eviction이 경계를 만들지 않는다. - 적중이 생기려면 TTL이 끝나기 전에 같은 키가 다시 들어와야 한다. 인스턴스 하나가 키 하나에 대해 TTL 안에 받는 요청 수를 계산했다.
1
2
3
키당 TTL 내 도달 횟수 = 요청률 × TTL ÷ (키 수 × 인스턴스 수)

1,600 × 2 ÷ (N × 4) ≥ 1  →  N ≤ 800
- 계산한 임계점은 N=800종이다.
- L2는 TTL 3초이고 클러스터 전체가 공유하므로 인스턴스 수로 나누지 않는다. 같은 식을 적용하면 상한은 약 4,800종이다.
- 800~4,800종 구간에서는 L1 적중률이 떨어져도 L2는 효과를 낼 것으로 예상했다.
예측 임계점은 L1 800종, L2 약 4,800종이다.
균등 접근 측정 결과
모든 종목을 같은 확률로 조회하는 조건에서 종목 수를 올려가며 측정
| 종목 수 | L1 적중률 | 인프로세스만 DB 로딩 | 2계층 DB 로딩 | L2 상환 배수 | 2계층 p99 |
|---|---|---|---|---|---|
| 100 | 88.8% | 20,933 | 3,393 | 6.2배 | 1.7ms |
| 300 | 72.6% | 51,183 | 10,124 | 5.1배 | 2.1ms |
| 800 | 50.0% | 144,199 | 37,873 | 3.8배 | 1.8ms |
| 1,088 | 42.4% | 165,825 | 49,500 | 3.3배 | 2.0ms |
| 3,000 | 21.0% | 147,037 | 69,951 | 2.1배 | 6.3ms |
| 5,000 | 13.7% | 160,271 | 93,192 | 1.7배 | 11.9ms |
- 3,000종과 5,000종 행의 로딩 수는 2분 측정값이므로 위쪽 행과 직접 비교하지 않는다.
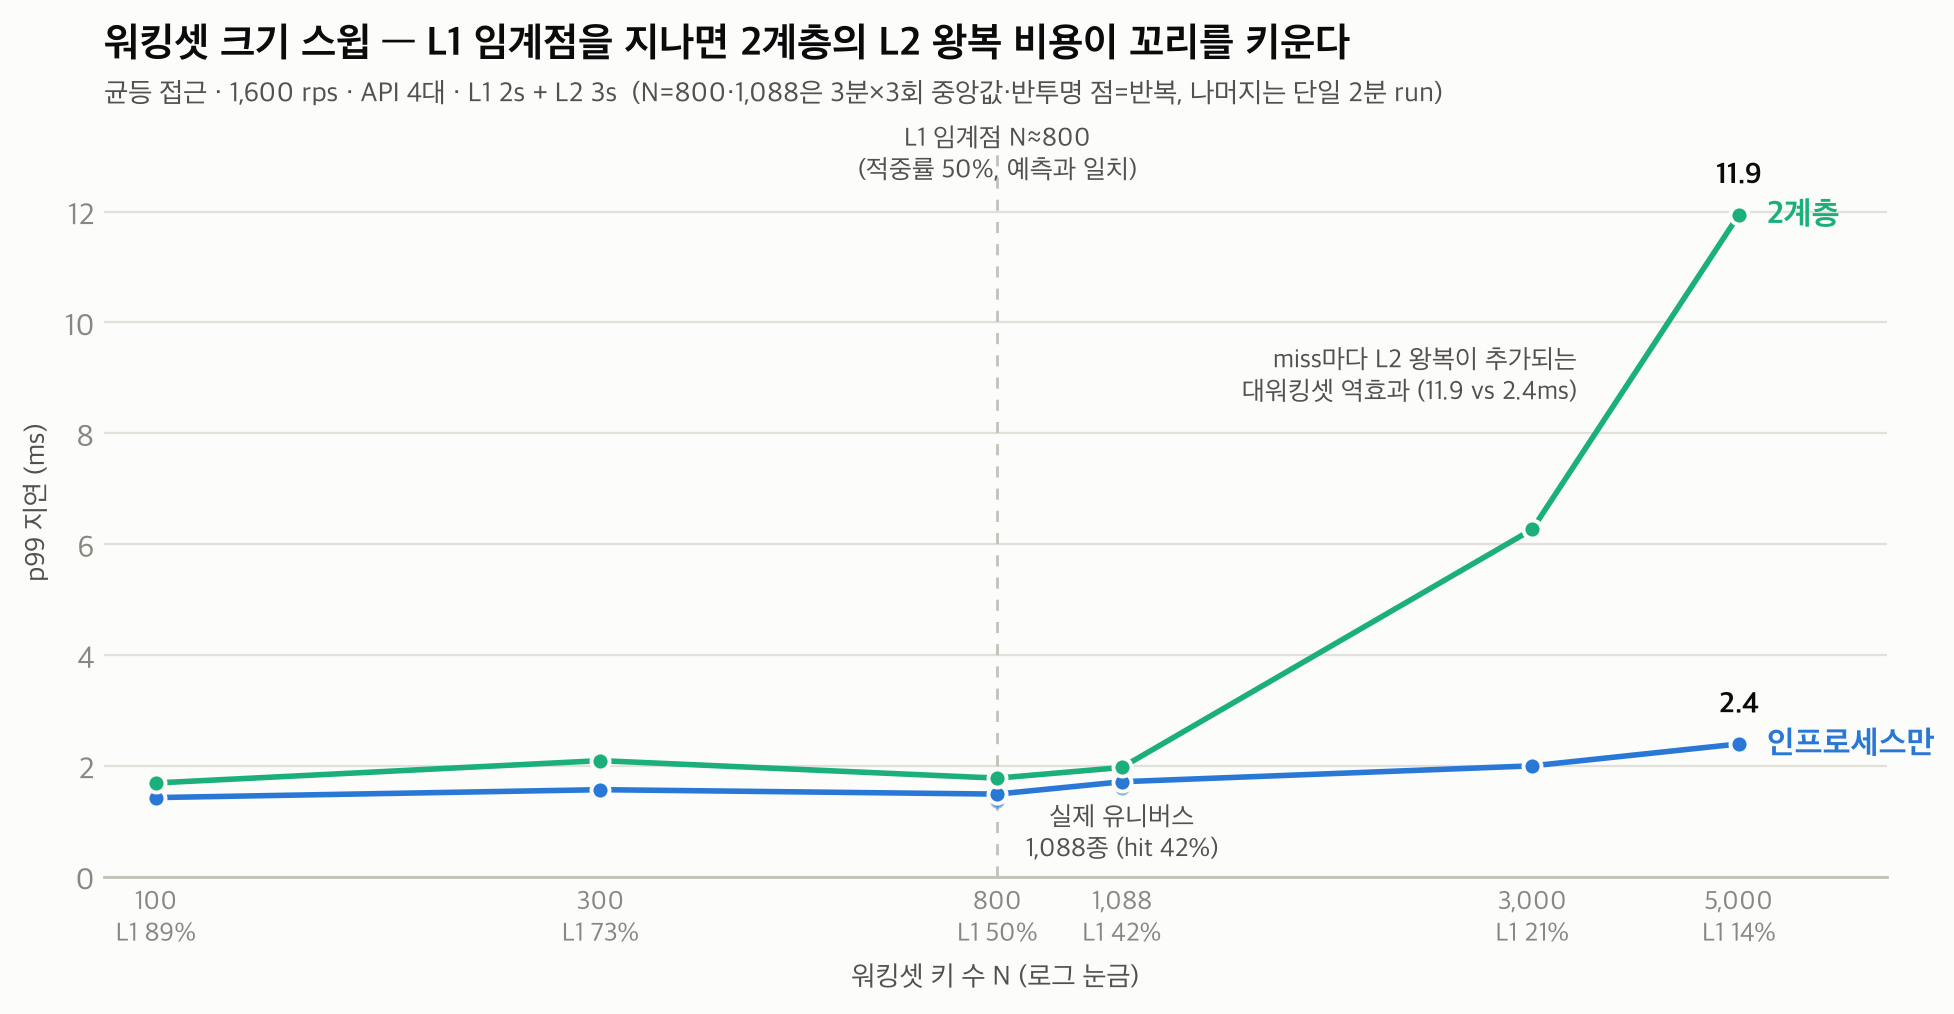
- L1 적중률이 50%를 하향 돌파하는 지점은 선형 보간으로 798~800종이었고, 두 모드에서 같은 자리였다. 예측 800과 일치한다.
- 수식은 낮은 종목 수 구간에서 특히 잘 맞았다. N=100의 예측치 87.5%와 실측 88.8%는 거의 겹친다.
- 높은 종목 수에서 붕괴가 예측보다 완만한 이유도 설명된다. 결정적 모델은 도달 횟수가 1 미만이면 적중률 0%를 예측하지만 실제 도착은 포아송이므로, 평균이 1 아래로 내려가도 우연히 TTL 창 안에 두 번 도착하는 키가 남는다. N=5,000에서 13.7%가 나온 것이 그 꼬리다.
- 이 수식으로 요청률·TTL·인스턴스 수가 바뀔 때마다 재검토 값을 다시 계산할 수 있다.
임계점은 예측한 자리인 798~800종에 있었다.
실제 유니버스와 임계점
국내 상장 ETF 수 약 1,088종은 표의 임계점 오른쪽
- 균등 접근 조건에서 이 종목 수를 인프로세스 캐시만으로 서빙하면 DB 로딩이 초당 약 920회가 된다.
- 앞선 실험에서 키 3종일 때 초당 5.9회였던 값과 비교하면 성격이 다른 부하다.
- 2계층 구성은 같은 조건에서 이를 3.3배 상환한다.
- 현재는 정책상 소수 종목만 서빙한다. 전체 유니버스를 균등하게 제공해야 한다면 이 측정값을 근거로 공유 캐시 도입을 다시 검토할 수 있다.
실제 유니버스는 이미 임계점 너머에 있지만, 현재 서빙 범위는 그 안쪽이다.
워킹셋 확대와 L2 감쇠
같은 도달률 논리가 L2에도 적용되어 상환 배수가 단조 감쇠
- 표의 L2 상환 배수 열은 6.2배에서 1.7배로 단조 감쇠한다. TTL 3초와 클러스터 합산으로 계산한 상한 약 4,800종에 부합하며, N=5,000에서 L2 자체 적중률은 41%까지 내려왔다.
- 공유 캐시는 임계점을 오른쪽으로 밀지만 없애지는 못한다.
- 2계층 구성의 p99는 N=3,000에서 6.3ms, N=5,000에서 11.9ms로 올라갔다. 같은 조건의 인프로세스 단독은 2.4ms였다.
- L2 왕복 비용은 miss마다 발생하므로, 총비용은 왕복 지연 × miss율이다. miss율이 낮을 때는 보이지 않다가 miss율이 커지면 응답 시간에 드러난다.
- DB 조회 횟수만 보고 도입을 결정하면 이 p99 변화를 놓치게 된다.
L2는 DB 로딩을 줄이면서도 응답을 느리게 만들 수 있었다.
접근 분포와 경계 이동
같은 1,088종에 요청의 90%가 인기 종목에 집중되는 현실적인 분포를 넣고 재측정
| 1,088종 | L1 적중률 | 인프로세스만 DB 로딩(3분) |
|---|---|---|
| 균등 접근 | 42.4% | 165,825 |
| 쏠림 분포(hot 90%) | 90.5% | 27,241 |
- 적중률이 42.4%에서 90.5%로 올라가고 DB 로딩은 6분의 1로 줄어든다. 초당 약 151회다. 임계점이 사실상 나타나지 않는다.
- 앞의 수식에서 키 수는 실제로 요청이 도달하는 유효 키 수에 가깝다. 쏠림 분포에서는 이 값이 전체 종목 수보다 훨씬 작아진다. 같은 종목 수라도 접근 분포에 따라 경계가 달라지는 이유다.
- 균등 접근은 최악 케이스에 가깝다. 트리거 표의 800종도 이 조건에서 문제가 시작되는 값이다.
- 실제 접근 분포를 확인하지 않고 종목 수만 보면 Redis 도입 시점을 너무 이르게 잡을 수 있다.
접근 분포가 쏠릴수록 경계는 오른쪽으로 이동한다.
조회 폭주 시나리오
시장 급변으로 조회가 몰리는 상황을 별도 확인
- 이 시스템이 실제로 버텨야 하는 구간이기 때문이다.
- 10초 램프로 도착률을 200 rps에서 4,000 rps로 올렸다(20~22배, 쏠림 99%).
- DB 로딩은 초당 3.3회에서 5.8회로 1.7배 늘었고, 온셋 10초 구간에 DB까지 도달한 요청은 42~45건이었다. 오류와 드롭은 0, p99는 3.0ms 이내였다.
- 2계층 대조군도 초당 0.7회에서 0.9회로 같은 경향이었다.
- 도착률은 20배가 됐지만 DB 로딩은 1.7배만 늘었다. 조회가 특정 종목에 몰릴수록 요청이 single-flight 뒤로 합쳐졌기 때문이다.
시장 급변 구간에서 캐시 효과는 더 커졌다.
회고와 한계
트리거 표의 첫 줄을 균등 접근 기준 약 800종, 분포 쏠림으로 완화됨으로 갱신
- 이제 종목 수와 접근 분포를 보고 재측정 시점을 정할 수 있다.
- 접근 분포는 균등과 90-10 두 점만 측정했고, 종목 키는 합성이며, 부하 발생기와 서버도 같은 로컬 머신에서 돌았다.
- 특정 분포의 정확한 임계점은 그 조건으로 다시 측정해야 한다.
- 수식을 남겨 뒀기 때문에 다음 실험의 범위는 더 빨리 좁힐 수 있다.
재검토 조건이 추정에서 측정값으로 바뀌었다.
재검토 조건의 경계를 균등 접근 기준 798~800종으로 측정했고, 접근 분포에 따라 경계가 움직이는 것도 확인했다.
다만 접근 분포는 두 점만, 키는 합성으로, 로컬 머신에서 측정했다는 한계가 남는다.
운영 환경의 실제 접근 분포와 종목 수가 확인되면, 남겨 둔 수식으로 재검토 값을 다시 계산한 뒤 같은 실험을 반복할 수 있다.
캐시 전략 시리즈
- 다중 인스턴스와 Redis 도입 판단
- 4가지 캐시 구성 부하 실험
- Caffeine 유지 결정 기록
- 캐시 경계 측정 (워킹셋 임계점)